
SSD NVMe Cho AI Local: Vì Sao Phải Là NVMe Và Vì Sao Chọn 4TB Nhiều Nhất?
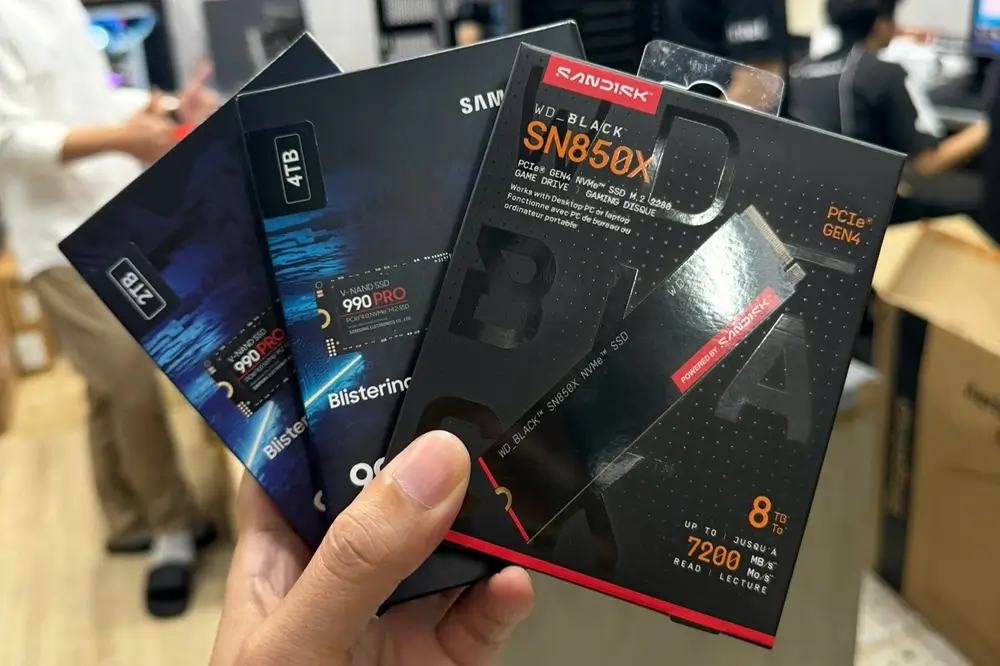
"Vì sao máy chạy AI local bắt buộc phải dùng SSD NVMe? Và tại sao ai cũng chốt mức dung lượng 4TB?" Đó là hai câu hỏi thường trực nhất mà khách hàng đặt ra khi cấu hình máy trạm tại Sicomp. SSD NVMe giúp rút ngắn thời gian nạp mô hình xuống còn chưa tới một nửa so với SSD SATA, còn 4TB là dung lượng tối thiểu để lưu trữ đồng thời vài mô hình nền lớn cùng các biến thể lượng tử hóa của chúng. Một phép đo công bố ghi nhận việc nạp một model 19,92 GiB mất 25,74 giây trên SSD NVMe PCIe 4.0 nhưng mất tới 57,97 giây trên SSD SATA. Trong khi đó, riêng bản gốc chưa nén của Llama 3.3 70B đã chiếm tới 141,1 GB bộ nhớ. Dưới đây là các số liệu thực tế giúp bạn ra quyết định đầu tư chính xác nhất.
I. SSD NVMe nạp model AI nhanh hơn SSD SATA bao nhiêu?
SSD NVMe nạp model nhanh hơn SSD SATA khoảng 2,25 lần trong các bài đo thực tế có công bố đầy đủ điều kiện testbed. Chuyên trang bestin-it đã sử dụng hệ thống máy trạm HP Z6 G4, trang bị card màn hình Radeon PRO W7900 48GB và công cụ llama-server để nạp mô hình Qwen3.6-35B-A3B bản Q4_K_S. Mỗi ổ cứng được chạy lặp lại 10 lần, xóa sạch bộ nhớ đệm cache hệ điều hành trước mỗi lượt đo (bestin-it, 29/07/2026):
| Ổ cứng thử nghiệm | Chuẩn giao tiếp | Thời gian nạp model | Tốc độ đọc đo được |
|---|---|---|---|
| Kingston KC3000 2TB | NVMe PCIe 4.0 x4 | 25,74 giây | 2.339,6 MB/s |
| Intel D3-S4510 480GB | SATA 6Gbps | 57,97 giây | 461,6 MB/s |
Nguyên nhân của khoảng cách này xuất phát từ giới hạn vật lý của chuẩn kết nối: Giao tiếp SATA thế hệ 3 bị chặn trần băng thông ở mức 600 MB/s (theo SATA-IO Revision 3.0 FAQ). Do đó, bất kể bạn mua ổ SSD SATA cao cấp cỡ nào, nó cũng không thể vượt qua rào cản này.
ĐỘ TRỄ CỐ ĐỊNH CỦA KHÂU KHỞI ĐỘNG MODEL:
Số liệu chỉ ra rằng: trong mỗi lần nạp model vào GPU, luôn có khoảng 14 đến 17 giây là thời gian xử lý cố định của CPU và phần mềm (khởi tạo bộ nhớ đệm, ánh xạ địa chỉ, biên dịch kernel). Ổ SSD NVMe tốc độ cao chỉ rút ngắn được phần thời gian đọc dữ liệu thô còn lại, chứ không thể triệt tiêu được 14–17 giây khởi tạo này.
II. Ổ SSD nhanh hơn có làm AI trả lời nhanh hơn không?
Câu trả lời là: KHÔNG, nếu mô hình đã nằm trong bộ nhớ VRAM của GPU.
Trong cùng bài đo của bestin-it, thời gian sinh ra token đầu tiên đạt 0,184 giây trên ổ NVMe và 0,178 giây trên ổ SATA. Hai con số này hoàn toàn tương đương nhau trong phạm vi sai số đo lường.
Ổ cứng chỉ hoạt động tích cực trong lúc khởi động nạp trọng số mô hình lên VRAM/RAM. Một nghiên cứu chuyên sâu về máy chủ chạy framework vLLM sử dụng cụm GPU NVIDIA H100 kết hợp mảng 4 ổ SSD PCIe 5.0 chạy RAID 0 cho thấy: thời gian đọc trọng số từ ổ đĩa chỉ chiếm vỏn vẹn 7% đến 10% tổng thời gian khởi động dịch vụ. Việc ép hệ thống đọc trực tiếp từ SSD thay vì từ bộ nhớ cache chỉ làm thay đổi tổng thời gian khởi động khoảng 1,04 lần; phần lớn thời gian còn lại phụ thuộc vào năng lực xử lý luồng của CPU (arXiv 2606.07362, 06/2026).
Ý nghĩa thực tế khi ra quyết định: Nếu cỗ máy của bạn là một AI Server khởi động một mô hình duy nhất vào đầu ngày rồi để chạy liên tục phục vụ người dùng, tốc độ SSD Gen4 hay Gen5 hầu như không tác động đến năng suất sinh chữ. Tốc độ ổ cứng chỉ đáng tiền khi bạn thường xuyên chuyển đổi giữa nhiều mô hình trong ngày, hoặc rơi vào trường hợp đặc biệt ở phần tiếp theo.
III. Khi nào tốc độ SSD quyết định trực tiếp tốc độ sinh chữ?
Tốc độ SSD quyết định trực tiếp tốc độ sinh chữ khi kích thước mô hình vượt quá tổng dung lượng RAM và VRAM sẵn có của hệ thống.
Khi rơi vào tình huống này, công cụ llama.cpp sẽ kích hoạt cơ chế ánh xạ bộ nhớ tệp (memory-mapped file - mmap) để đọc trực tiếp các khối trọng số từ ổ SSD trong lúc tính toán: mỗi khi sinh ra một token mới, GPU buộc phải kéo một phần dữ liệu mô hình từ SSD lên. Một trường hợp điển hình được chia sẻ trên cộng đồng Hugging Face: người dùng chạy mô hình DeepSeek-R1 bản Q2_K_XL nặng tới 212 GB trên một cỗ máy chỉ có 96 GB RAM và 24 GB VRAM ghi nhận tốc độ sinh chữ đạt khoảng 1,0 đến 1,3 tokens/giây, trong đó ổ SSD PCIe 5.0 phải duy trì tốc độ đọc liên tục từ 2 đến 5 GB/s (Hugging Face, thảo luận unsloth/DeepSeek-R1-GGUF #13, 01/2025).
RANH GIỚI THỰC TẾ GIỮA TEST MODEL VÀ PRODUCTION:
Ở kịch bản offloading qua mmap, ổ SSD PCIe 5.0 nhanh hơn sẽ giúp ra chữ nhanh hơn rõ rệt, trong khi ổ SATA bị tắc nghẽn hoàn toàn và không thể sử dụng.
Tuy nhiên, tốc độ 1 token/giây chỉ phù hợp để các kỹ sư chạy thử nghiệm cấu trúc câu trả lời của mô hình trước khi trình sếp duyệt ngân sách mua GPU. Nó hoàn toàn chưa đủ tốc độ phục vụ nhân viên trong doanh nghiệp. Nếu nhu cầu lâu dài là vận hành các mô hình tầm cỡ DeepSeek-R1, giải pháp đúng đắn là đầu tư thêm GPU và VRAM, còn ổ Gen5 chỉ là cầu nối để test sớm với chi phí tối ưu.
IV. Một model AI local chiếm bao nhiêu dung lượng ổ cứng?
Mỗi mô hình AI chiếm từ vài Gigabyte đến hàng trăm Gigabyte trên đĩa cứng, tùy thuộc vào số lượng tham số (parameters) và định dạng lượng tử hóa. Bảng dưới đây đối chiếu dung lượng thực tế của các tệp trọng số trích xuất trực tiếp từ kho lưu trữ Hugging Face (kho Unsloth) vào ngày 29/09/2026:
| Tên Model AI | Bản gốc (FP16/BF16) | GGUF Q4_K_M | GGUF Q8_0 | Ý nghĩa lưu trữ thực tế |
|---|---|---|---|---|
| gpt-oss-20b | 13,8 GB | 11,6 GB | 12,1 GB | Ổ 1TB chứa thoải mái nhiều bản |
| Llama 3.1 8B Instruct | 16,1 GB | 4,9 GB | Không tra cứu | Model nhập môn, chiếm rất ít dung lượng |
| Qwen3-32B | 65,5 GB | 19,8 GB | 34,8 GB | Giữ đủ 3 bản tiêu tốn 120,1 GB |
| gpt-oss-120b (MoE) | 65,3 GB | 62,8 GB | 63,4 GB | Lượng tử hóa hầu như không giảm dung lượng |
| Llama 3.3 70B Instruct | 141,1 GB | 42,5 GB | 75,0 GB | Giữ đủ 3 bản ngốn 258,6 GB |
| Qwen3-235B-A22B | 470,2 GB | 142,2 GB | 249,9 GB | Một model chiếm gần nửa ổ 2TB |
| DeepSeek-R1 Full | 688,6 GB | 404,4 GB | 713,3 GB | Ba bản cộng lại ngốn 1.806,3 GB! |
Cái bẫy khi tải mô hình từ Hugging Face: Kho lưu trữ Llama 3.3 70B chính thức trên Hugging Face có dung lượng tổng lên tới 282,3 GB vì nó chứa thêm một thư mục original/ bên cạnh các tệp checkpoint chuẩn. Nếu lập trình viên gõ lệnh git clone mà không lọc bỏ thư mục thừa, ổ cứng sẽ lập tức bị nuốt trọn gần 300GB dữ liệu.
V. Vì sao ổ cứng 1TB hay 2TB đầy nhanh chóng trên máy chạy AI?
Một ổ cứng 1TB hoặc 2TB sẽ bị lấp đầy chỉ sau vài tuần vì kỹ sư AI không bao giờ giữ duy nhất một mô hình. Trong công việc hàng ngày, họ luôn phải lưu trữ đồng thời:
- Nhiều mô hình và nhiều định dạng lượng tử hóa: Để so sánh câu trả lời, team cần giữ bản gốc FP16, bản Q8_0 để làm chuẩn và bản Q4_K_M để chạy thực tế cho nhẹ máy.
- Image Container môi trường chạy: Bản image Docker
vllm/vllm-openaimới nhất nặng tới 8,73 GB ở dạng nén (giải nén ra chiếm hơn 15GB), imageollama/ollamanặng 3,75 GB (Docker Hub, 29/09/2026). - Checkpoint khi tinh chỉnh: Đây là chỗ nuốt dung lượng dữ dội nhất. Thuật toán tối ưu hóa AdamW lưu 8 byte cho mỗi tham số, bản sao lưu trọng số FP32 lưu thêm 4 byte. Theo tài liệu Hugging Face Transformers, khi tinh chỉnh toàn phần một model 8B kèm trạng thái optimizer, mỗi checkpoint tiêu tốn: 12 bytes × 8 tỷ tham số ≈ 96 GB cho mỗi bản lưu.
BÀI TOÁN CỘNG DUNG LƯỢNG THỰC TẾ CỦA MỘT TEAM AI (TÍNH BẰNG GIGABYTE):
- 3 bản Llama 3.3 70B (Gốc + Q8 + Q4): 258,6 GB
- 3 bản Qwen3-32B: 120,1 GB
- 1 bản DeepSeek-R1 Q4: 404,4 GB
- 3 checkpoint lưu quá trình fine-tune model 8B: 288,0 GB
- 2 image container Docker (vLLM + Ollama): 12,5 GB
Tổng cộng: 1.083,6 GB (Đã vượt quá dung lượng khả dụng của 1 ổ SSD 1TB, và chiếm trọn hơn nửa ổ 2TB — chưa tính hệ điều hành, tập dữ liệu train và Vector Database!).
VI. Dữ liệu thực tế tại Sicomp: 90% khách hàng chốt ổ SSD 4TB nào?
Trong giai đoạn 12 tháng gần nhất (từ 10/2025 đến 09/2026), theo số liệu thống kê dự án do Sicomp tổng hợp: Khoảng 90% hệ thống PC AI và máy trạm AI local xuất xưởng tại Sicomp đều được khách hàng lựa chọn dung lượng SSD 4TB.
Cơ cấu phân bổ trong nhóm 4TB phản ánh xu hướng rất thực tế:
- Khoảng 70% khách hàng chọn Samsung 990 PRO 4TB (PCIe 4.0): Đây là "lựa chọn quốc dân" vì ổ Gen4 đã khai thác được phần lớn khoảng cách tốc độ so với SATA (nạp model 25 giây thay vì 58 giây), trong khi mức chi phí đầu tư vô cùng hợp lý và hoạt động cực kỳ mát mẻ.
- Khoảng 20% khách hàng chọn SanDisk Optimus GX Pro 8100 4TB (PCIe 5.0): Dòng sản phẩm flagship mới nhất của SanDisk (mã SDSP82400TAH-000E0) tốc độ đọc 14.900 MB/s.
- Khoảng 10% khách hàng chọn Samsung 9100 PRO 4TB (PCIe 5.0): Đỉnh cao của Samsung trang bị chip điều khiển Presto 5nm và tốc độ đọc 14.800 MB/s.
VII. So sánh chi tiết 3 mẫu SSD 4TB hàng đầu cho máy AI
Cả ba mẫu SSD này đều sở hữu chỉ số độ bền ghi 2.400 TBW và chế độ bảo hành 5 năm chính hãng ở phiên bản 4TB. Khác biệt lớn nhất nằm ở băng thông giao tiếp PCIe và tốc độ đọc ghi tuần tự:
| Thông số bản 4TB | Samsung 990 PRO 4TB | Samsung 9100 PRO 4TB | SanDisk Optimus GX Pro 8100 4TB |
|---|---|---|---|
| Chuẩn giao tiếp PCIe | PCIe Gen 4.0 x4 | PCIe Gen 5.0 x4 | PCIe Gen 5.0 x4 |
| Tốc độ Đọc tuần tự | 7.450 MB/s | 14.800 MB/s | 14.900 MB/s (Đỉnh bảng) |
| Tốc độ Ghi tuần tự | 6.900 MB/s | 13.400 MB/s | 14.000 MB/s |
| Bộ nhớ đệm DRAM Cache | 4GB LPDDR4 | 4GB LPDDR4X | nCache 4.0 + DRAM LPDDR4X |
| Độ bền ghi dữ liệu (TBW) | 2.400 TBW | 2.400 TBW | 2.400 TBW |
| Trang bị giáp tản nhiệt | Tùy chọn Heatsink rời | Bản mạch trần (Dùng tản Main) | Heatsink nhôm phay nguyên khối |
| Chính sách bảo hành hãng | 60 Tháng (5 năm) | 60 Tháng (5 năm) | 60 Tháng (5 năm) |
BÀI TOÁN ĐỘ BỀN 2.400 TBW CHO MÁY AI: Nếu mỗi ngày bạn lưu đều đặn 1 bản checkpoint nặng 96 GB (tương đương 35.040 GB/năm), thì phải mất khoảng: 2.400.000 GB / 35.040 GB mỗi năm ≈ 68,5 năm mới cạn hết hạn mức ghi dữ liệu của ổ cứng. Do đó, chỉ số TBW trên các dòng SSD TLC cao cấp này gần như không bao giờ là giới hạn thực tế đối với máy AI.
VIII. Những điểm yếu và lưu ý kỹ thuật cần biết trước khi lắp
Sicomp chỉ ra 3 điểm lưu ý đối với hệ thống lưu trữ máy AI:
- Cập nhật Firmware cho Samsung 990 PRO ngay khi nhận máy: Dòng 990 PRO từng gặp sự cố tụt chỉ số sức khỏe S.M.A.R.T bất thường trên bản firmware xuất xưởng
0B2QJXD7. Bản cập nhật1B2QJXD7(và các bản mới hơn) đã vá dứt điểm lỗi này (Puget Systems, 14/03/2023). Khi nhận máy tại Sicomp, kỹ thuật viên luôn hỗ trợ cập nhật firmware mới nhất qua phần mềm Samsung Magician. - SSD PCIe Gen5 tỏa nhiệt lớn và bắt buộc phải có luồng gió (Airflow): Datasheet Samsung 9100 Pro khuyến cáo nhiệt độ hoạt động từ 0°C đến 70°C kèm dòng lưu ý "Proper airflow recommended". Trong các cỗ máy AI lắp từ 2 đến 4 GPU tỏa nhiệt hàng ngàn Watt, khe cắm M.2 nằm sát khe PCIe sẽ phải chịu nhiệt lượng khổng lồ. Ổ Gen5 bắt buộc phải dùng phiến tản nhiệt dày bản hoặc tản nhiệt chủ động kèm quạt.
- Tuyệt đối không dùng SSD chip nhớ QLC để fine-tune AI: Các dòng SSD sử dụng chip nhớ QLC (như Samsung 870 QVO 4TB) chỉ có độ bền ghi 1.440 TBW và bảo hành 3 năm (so với 2.400 TBW và 5 năm của TLC). Tệ hơn, khi bộ nhớ đệm SLC cache bị đầy sau khi ghi vài chục GB, tốc độ ghi thực tế của chip QLC có thể tụt thảm hại xuống mức chỉ còn 80–160 MB/s (chậm hơn cả ổ cứng cơ HDD!).
IX. Mua ổ SSD 4TB khi giá chip nhớ NAND đang tăng: Có nên chốt ngay?
CÓ, nếu kế hoạch dự án của bạn cần dùng máy trong vòng 12 tháng tới.
Báo cáo thị trường bán dẫn mới nhất từ TrendForce (21/09/2026) chỉ ra rằng: Giá hợp đồng SSD doanh nghiệp trong Quý 4/2026 tiếp tục tăng từ 23% đến 28% so với quý trước, trong khi giá chip nhớ NAND flash nói chung tăng từ 15% đến 20% do các nhà sản xuất bán dẫn (Samsung, SK Hynix, Micron) dồn công suất wafer sang sản xuất bộ nhớ HBM3e/HBM4 cho máy chủ AI trung tâm dữ liệu. Lịch sử từng ghi nhận giá bán lẻ của Samsung 990 Pro 4TB trên thị trường quốc tế vọt tăng gấp 3 lần trong các đợt khan hàng (Dân trí, 11/05/2026). Việc chần chừ chờ giá hạ chỉ khiến doanh nghiệp phải chi trả mức ngân sách đắt đỏ hơn.
3 CÂU HỎI CẦN HỎI NHÀ CUNG CẤP:
- Chính sách đổi trả khi ổ lỗi: Ổ hỏng được đổi mới ngay lập tức hay phải gửi đi bảo hành sửa chữa, và thời gian chờ đợi là bao lâu? (Tại Sicomp: áp dụng chính sách đổi mới trong 3 năm đầu cho SSD).
- Bảo mật dữ liệu nội bộ: Đối với ổ cứng chứa mô hình fine-tune và dữ liệu nhạy cảm của doanh nghiệp, quy trình xử lý tiêu hủy hay bảo lưu dữ liệu khi bảo hành được thực hiện thế nào?
- Điều kiện hết hạn bảo hành: Hạn bảo hành 5 năm kết thúc theo thời gian thực tế hay theo chỉ số TBW ghi trên phần mềm? (Quy chuẩn chung: Tùy điều kiện nào đến trước).
X. Tổng kết: Bạn nên chọn chiếc SSD nào cho cỗ máy AI của mình?
| Kịch bản sử dụng thực tế | Model SSD đề xuất | Căn cứ kỹ thuật |
|---|---|---|
| Máy trạm 1 GPU, chạy các model ≤70B quantized, thỉnh thoảng thử model mới | Samsung 990 PRO 4TB (PCIe 4.0) | Chi phí tối ưu nhất, đã lấy được phần lớn khoảng chênh tốc độ so với SATA, mát mẻ. |
| Hệ thống đổi model liên tục nhiều lần/ngày, hoặc cần mmap model vượt trần VRAM/RAM | SanDisk Optimus GX Pro 8100 4TB hoặc Samsung 9100 PRO 4TB (PCIe 5.0) | Tốc độ đọc gần 15.000 MB/s, yêu cầu bo mạch chủ có khe Gen5 và tản nhiệt đối lưu tốt. |
| Máy chỉ chạy cố định 1 mô hình nhỏ (như Llama 8B, Qwen 7B) | Giữ nguyên ổ 1TB / 2TB sẵn có | Dung lượng hiện tại đủ đáp ứng, chưa cần tốn chi phí nâng cấp lên 4TB. |
TƯ VẤN HẠ TẦNG LƯU TRỮ VÀ CẤU HÌNH MÁY TRẠM AI CHUYÊN NGHIỆP TẠI SICOMP!
Quý doanh nghiệp và các nhóm nghiên cứu AI đang cần tính toán dung lượng tệp trọng số, đo đạc kích thước mô hình hoặc lựa chọn giải pháp SSD NVMe 4TB chính hãng tối ưu TCO nhất? Hãy liên hệ ngay với đội ngũ kỹ sư giải pháp của Sicomp qua hotline 0384.734.666 để được tư vấn chuyên sâu hôm nay!
Bài viết liên quan
Thị Trường PC Toàn Cầu Q3 2026 Sụt Giảm 20.1%: Áp Lực Tồn Kho Và Giá Linh Kiện
Báo cáo IDC Q3 2026: Sản lượng xuất xưởng PC toàn cầu giảm 20.1% xuống 62.7 triệu máy do dư âm ôm hàng nửa đầu năm và giá phần cứng tăng cao. HP và Dell giảm sâu.
LiquidJet Diamond: Tích Hợp Kim Cương Vào Tấm Làm Mát Tăng 35% Token/Watt Cho Chip AI
Frore Systems ra mắt LiquidJet Diamond tích hợp tấm kim cương cho phiến lạnh AI: giảm nhiệt thêm 10°C, tản điểm nóng tới 770 W/cm2, tăng 35% doanh thu Token/Watt.
Đánh giá Supermicro AOC-S100G-M2C-P: Khi nào nên chọn
Đánh giá card mạng Supermicro AOC-S100G-M2C-P hai cổng 100GbE: trần băng thông PCIe 3.0 x16, lịch hỗ trợ driver ConnectX-4 và khi nào nên chọn.
NVIDIA Ra Mắt DGX Station Chạy Windows: GB300, 748GB Bộ Nhớ, 20 PFLOPs
NVIDIA công bố phiên bản DGX Station chạy Windows trang bị siêu chip GB300 Blackwell Ultra, 20 PFLOPs AI compute, 748GB Unified Memory đối đầu Threadripper Halo Station.