
So Sánh RTX PRO 6000 Server Edition vs H200 NVL
Khi triển khai hạ tầng tính toán AI nội bộ chuẩn tủ Rack sử dụng khe cắm PCIe tiêu chuẩn thay vì nền tảng SXM đắt đỏ, các doanh nghiệp và phòng lab nghiên cứu thường đứng trước hai lựa chọn phần cứng đầu bảng của NVIDIA: NVIDIA RTX PRO 6000 Blackwell Server Editio và NVIDIA H200 NVL. Cả hai đều thiết kế tản nhiệt thụ động 2 khe cắm tối ưu cho luồng gió áp suất cao của vỏ máy chủ, nhưng lại khác nhau hoàn toàn về bộ nhớ và khả năng liên kết đa GPU. Bài viết dưới đây từ Sicomp sẽ phân tích chi tiết thông số, hiệu năng thực tế và định hướng đầu tư máy chủ H200 NVL cũng như cụm máy chủ RTX PRO 6000 phù hợp nhất.
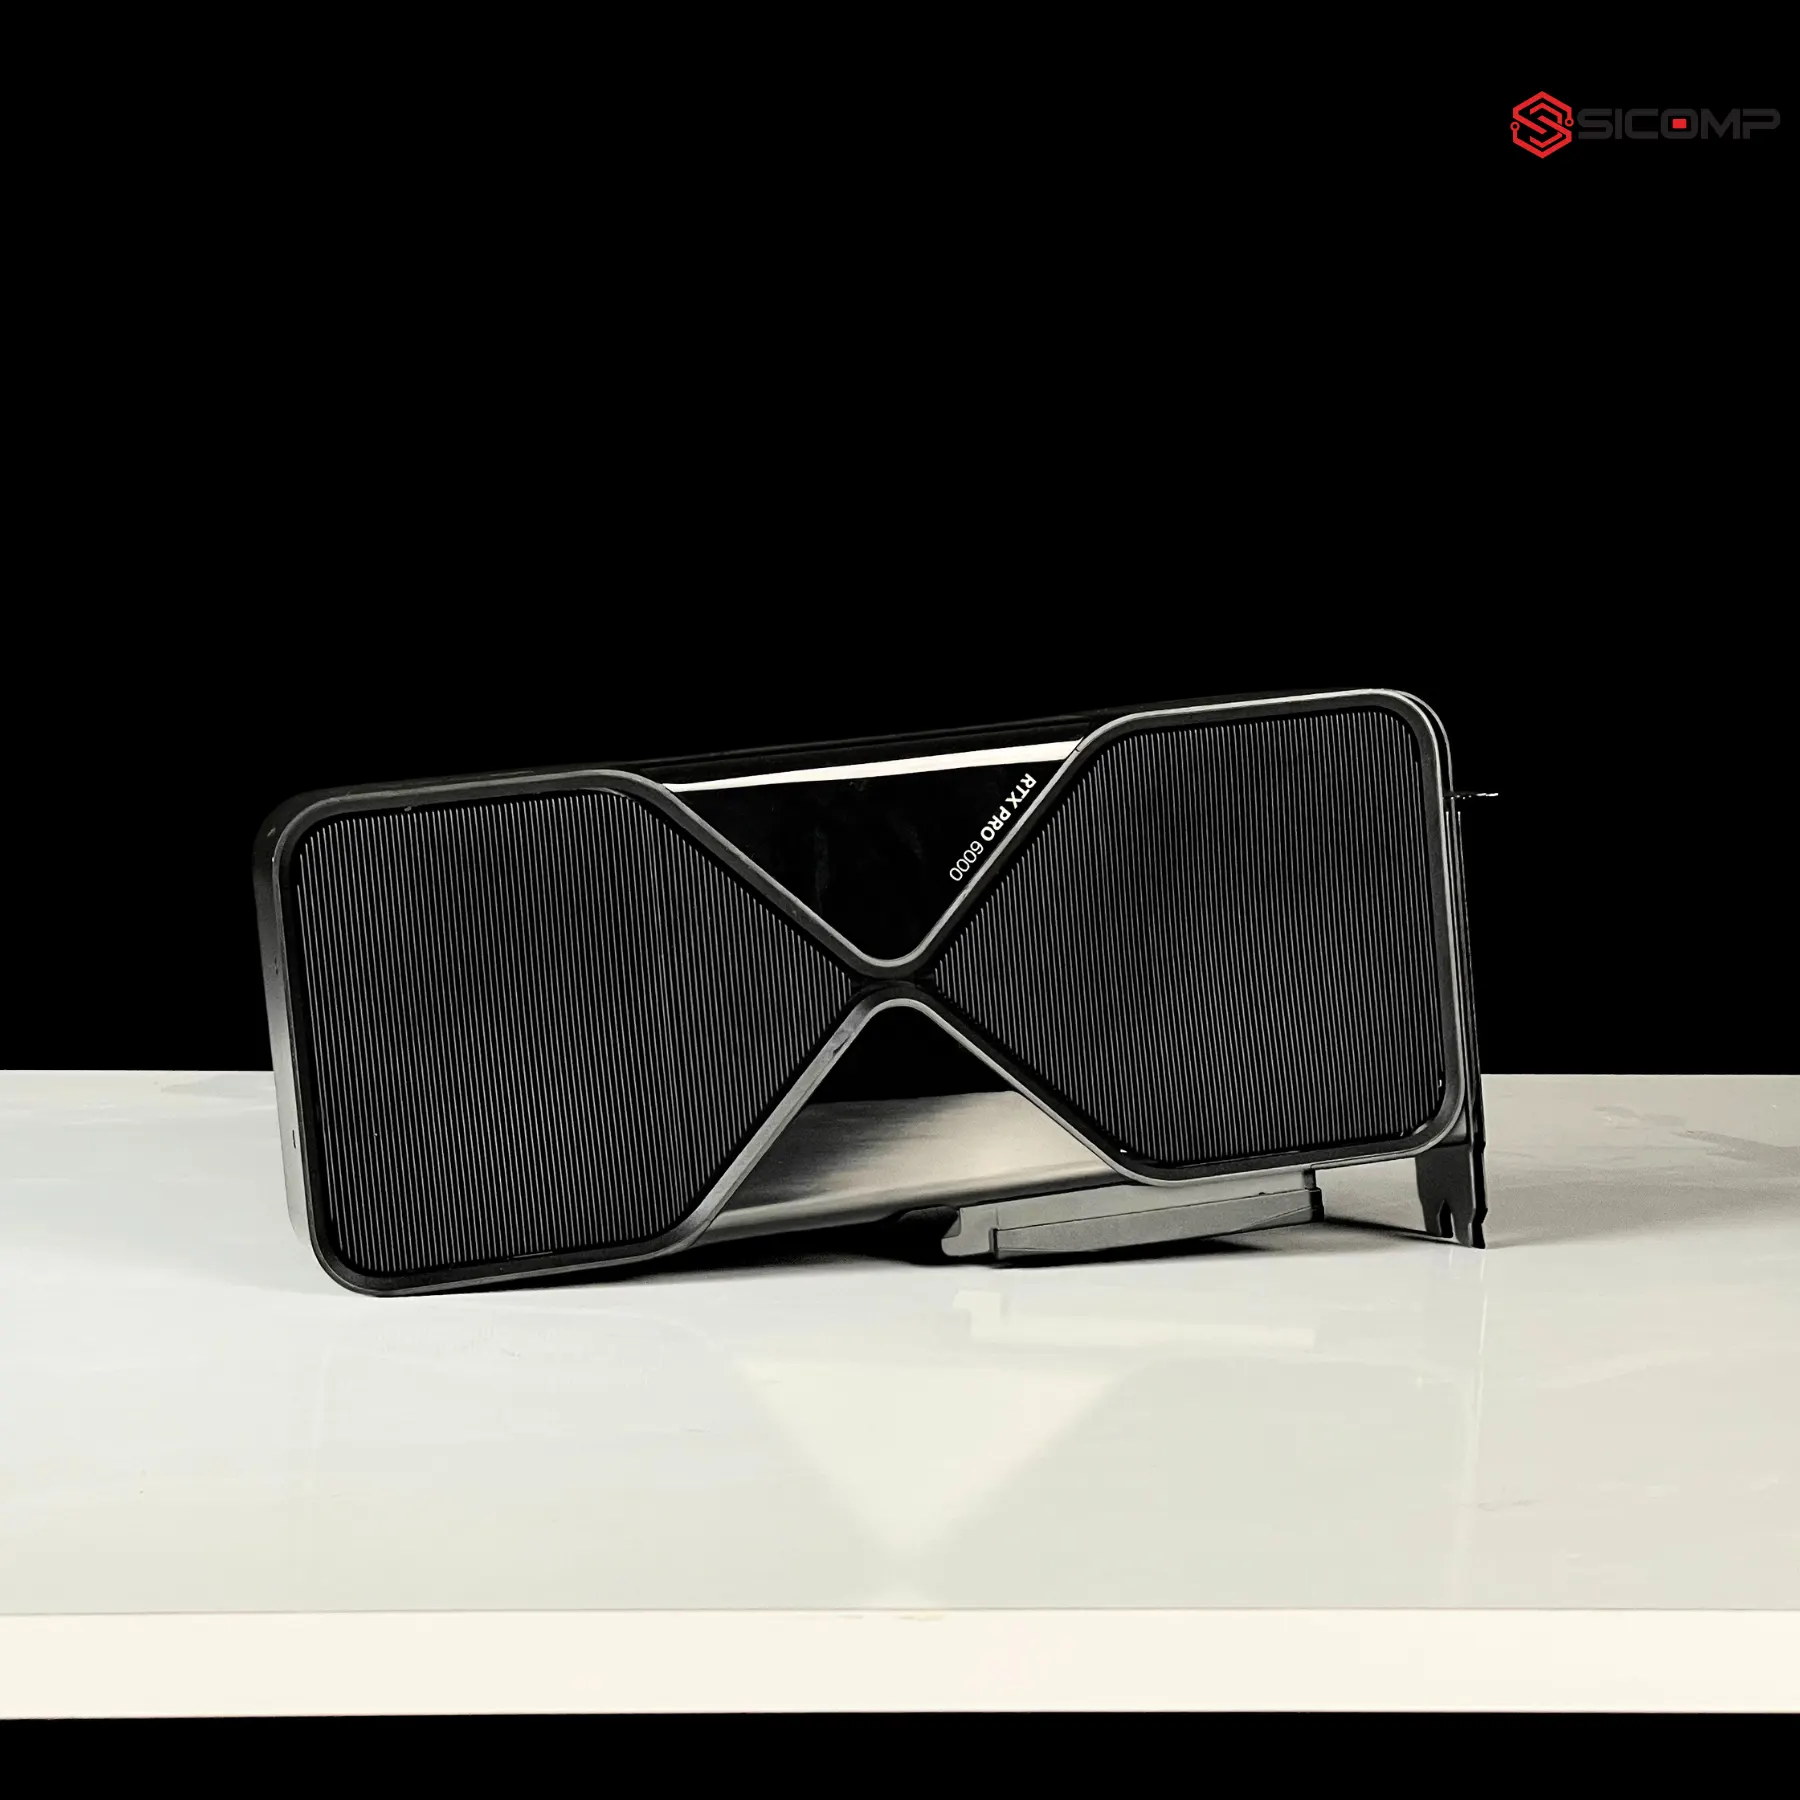
I. Bảng so sánh thông số kỹ thuật: RTX PRO 6000 Server Edition vs H200 NVL
Bảng dữ liệu dưới đây đối chiếu trực tiếp các thông số kiến trúc giữa hai dòng bộ tăng tốc đồ họa chuẩn PCIe Gen 5.0 của NVIDIA:
| Tiêu chí kỹ thuật | NVIDIA RTX PRO 6000 Server Edition | NVIDIA H200 NVL |
|---|---|---|
| Kiến trúc vi xử lý (GPU) | NVIDIA Blackwell (GB202 Enterprise) | NVIDIA Hopper (GH100) |
| Dung lượng & Loại bộ nhớ VRAM | 96 GB GDDR7 (Hỗ trợ ECC) | 141 GB HBM3e (Hỗ trợ ECC) |
| Giao tiếp & Băng thông bộ nhớ | 512-bit • Băng thông 1,8 TB/s | 4.992-bit • Băng thông 4,8 TB/s |
| Cấu trúc nhân xử lý | 24.064 CUDA Cores • 752 Tensor Cores (Gen 5) • 188 RT Cores | 16.896 FP32 Cores • 528 Tensor Cores (Gen 4) • Không có RT Cores |
| Kết nối liên card tốc độ cao (NVLink) | Không hỗ trợ cầu nối NVLink (Giao tiếp qua PCIe 5.0 x16) | Hỗ trợ NVLink Bridge 900 GB/s (Gộp 2 hoặc 4 GPU) |
| Hỗ trợ phân chia ảo hóa MIG | Tối đa 4 phân vùng MIG (mỗi phân vùng 24GB) | Tối đa 7 phân vùng MIG (mỗi phân vùng ~16,5GB – 20GB) |
| Kiểu dáng & Cơ chế tản nhiệt | Dual-Slot PCIe 5.0 x16 • Tản nhiệt thụ động (Passive) | Dual-Slot PCIe 5.0 x16 • Tản nhiệt thụ động (Passive) |
| Công suất tiêu thụ tối đa (TDP) | Lên tới 600 W | Lên tới 600 W (Cấu hình linh hoạt 350W – 600W) |
II. Khác biệt cốt lõi về băng thông bộ nhớ và cầu nối NVLink 900GB/s
Dù cả hai mẫu card đều dùng chung chuẩn kích thước 2 khe cắm và mức công suất trần 600W, bản chất hiệu năng của chúng được phân tách rõ rệt bởi hai công nghệ nền tảng:
BẢN CHẤT CHÊNH LỆCH KIẾN TRÚC TRONG TẢI AI NẶNG:
- Băng thông bộ nhớ 4,8 TB/s của H200 NVL gấp 2,6 lần GDDR7: Trong các tác vụ suy luận LLM Inference có kích thước ngữ cảnh dài và phục vụ nhiều người dùng đồng thời, tốc độ sinh token bị giới hạn trực tiếp bởi băng thông bộ nhớ chứ không phải số nhân tính toán. Công nghệ bộ nhớ xếp chồng 141GB HBM3e giúp máy chủ H200 NVL đạt băng thông 4,8 TB/s, vượt xa mức 1,8 TB/s của bộ nhớ GDDR7 trên RTX PRO 6000 Server Edition.
- Cầu nối NVLink 900 GB/s gộp vùng nhớ trực tiếp: NVIDIA H200 NVL hỗ trợ lắp cầu nối vật lý NVLink tốc độ 900 GB/s (gấp 7 lần băng thông của khe PCIe 5.0 x16). Khi ghép 2 card H200 NVL, hệ thống tạo thành một khối tài nguyên hợp nhất 282GB VRAM HBM3e và băng thông 9,6 TB/s; khi ghép 4 card đạt tới 564GB VRAM. Ngược lại, RTX PRO 6000 Server Edition không có cầu nối NVLink nên các card phải trao đổi dữ liệu gián tiếp qua bus PCIe 5.0 của CPU, làm tăng độ trễ khi huấn luyện phân tán quy mô lớn.
III. Thế mạnh riêng của RTX PRO 6000 Blackwell Server Edition
Mặc dù thua kém về băng thông HBM3e và kết nối NVLink, NVIDIA RTX PRO 6000 Server Edition lại sở hữu những ưu điểm chiến lược nhờ kiến trúc Blackwell mới và chi phí đầu tư dễ tiếp cận hơn:
- Hỗ trợ tập lệnh FP4 gốc trên Tensor Core thế hệ 5: Kiến trúc Blackwell bổ sung khả năng tăng tốc phần cứng cho định dạng dữ liệu siêu thấp 4-bit, giúp tăng gấp đôi thông lượng suy luận AI so với định dạng FP8 truyền thống và cắt giảm một nửa dung lượng bộ nhớ chiếm dụng của mô hình.
- Tích hợp 188 nhân Ray Tracing và bộ mã hóa/giải mã NVENC/NVDEC đầy đủ: Trong khi H200 NVL là dòng chip thuần tính toán khoa học không có nhân đồ họa xuất hình hay nhân dò tia, RTX PRO 6000 Server Edition đảm nhiệm xuất sắc các tác vụ kết xuất đồ họa 3D máy chủ, mô phỏng Omniverse, VDI ảo hóa máy trạm đồ họa và xử lý luồng video AI thời gian thực.
- Tỷ suất chi phí trên mỗi Gigabyte VRAM tối ưu: Việc sử dụng chip nhớ 96GB GDDR7 giúp chi phí đầu tư của RTX PRO 6000 Server Edition thấp hơn đáng kể so với dòng H200 NVL dùng bộ nhớ HBM3e đắt đỏ, phù hợp cho các doanh nghiệp triển khai nhiều node suy luận độc lập.
IV. Tư vấn lựa chọn: Khi nào nên đầu tư máy chủ H200 NVL hay RTX PRO 6000?
Từ kinh nghiệm thiết kế và bàn giao các cụm PC AI và máy chủ tính toán doanh nghiệp, đội ngũ kỹ sư Sicomp phân định rõ hai kịch bản đầu tư chuẩn xác:
- Đầu tư hệ thống máy chủ H200 NVL khi: Doanh nghiệp cần huấn luyện từ đầu (Pre-training), tinh chỉnh sâu (Full Fine-tuning) các mô hình ngôn ngữ khổng lồ trên 70B – 405B tham số, hoặc vận hành dịch vụ API AI phục vụ hàng trăm yêu cầu truy cập đồng thời với độ trễ thấp nhất. Sức mạnh của 141GB HBM3e và cầu nối NVLink 900 GB/s giúp xóa bỏ hoàn toàn nút thắt giao tiếp đa GPU trên các dòng máy chủ Rack 2U/4U chuẩn doanh nghiệp.
- Đầu tư máy chủ RTX PRO 6000 Server Edition khi: Nhu cầu tập trung vào chạy suy luận mô hình LLM kích thước vừa và lớn (từ 32B đến 70B lượng tử hóa FP4/FP8) trên từng card độc lập, xây dựng hạ tầng AI tạo sinh hình ảnh/video, kết hợp ảo hóa VDI cho đội ngũ kỹ sư thiết kế 3D/CAD/CAE mà vẫn tối ưu hóa được ngân sách đầu tư ban đầu.
Lưu ý kỹ thuật quan trọng: Cả hai dòng card đều có công suất lên tới 600W mỗi card. Do đó, linh kiện bắt buộc phải được lắp đặt trong các khung máy chủ chuyên dụng có hệ thống quạt áp suất tĩnh cao và bộ nguồn máy chủ công suất từ 2000W đến 3200W chuẩn Platinum/Titanium.
Tại Sicomp, chúng tôi cung cấp trọn gói giải pháp phần cứng máy chủ AI đồng bộ, hỗ trợ kiểm thử chịu tải thực tế và bàn giao tận nơi theo tiêu chuẩn phòng Data Center của doanh nghiệp.
Bài viết liên quan
MIG Và Ảo Hóa GPU Trên NVIDIA Blackwell Là Gì?
Tìm hiểu công nghệ MIG và vGPU trên dòng NVIDIA Blackwell từ GeForce RTX 5090 đến RTX PRO 6000 Server Edition: Cách chia 1 GPU cho 4–48 người dùng
So Sánh 3 Loại Tản Nhiệt Cho Threadripper PRO 9965WX
Thử nghiệm thực tế 3 tản nhiệt be quiet! Silent Loop 3 360, ASRock WS TR 360D và DeepCool StationX 622 trên Threadripper PRO 9965WX qua 9 kịch bản tải tại Sicomp.
Đánh Giá Hiệu Năng Tản Nhiệt Khí DeepCool StationX 622
Thử nghiệm tản nhiệt khí DeepCool StationX 622 trên Threadripper PRO 9965WX: Đạt 59.526 điểm Cinebench R23 ở mức 300W (77,1°C) và 59.511 điểm ở mặc định 350W tại Sicomp.
Đánh Giá Hiệu Năng Tản Nhiệt ASRock WS TR 360D
Thử nghiệm tản nhiệt nước AIO ASRock WS TR 360D trên Threadripper PRO 9965WX: Đạt 60.210 điểm Cinebench R23 ở 350W (79°C) và cực mát 67,8°C ở mức 300W tại Sicomp.