
NVIDIA giới thiệu DGX Spark 64GB cho người dùng AI Local
NVIDIA vừa chính thức giới thiệu biến thể bổ sung của dòng máy tính AI để bàn DGX Spark: phiên bản 64GB Unified Memory với mức giá khởi điểm 4.999 USD, mở bán thương mại từ ngày 23/10/2026 thông qua đối tác OEM (Acer, ASUS, Dell, Gigabyte, HP và MSI) và không phát hành bản Founders Edition. Điểm nghịch lý lớn nhất nằm ở phương trình tài chính: Một năm trước, bản 128GB Founders Edition ra mắt ở mức 3.999 USD; hôm nay, người mua phải trả thêm 1.000 USD để nhận lại một dung lượng RAM bị cắt giảm một nửa. Điều này phản ánh sự dịch chuyển sâu sắc của toàn ngành bán dẫn khi GPU không còn là linh kiện duy nhất bị nghẽn nguồn cung, mà chính dung lượng bộ nhớ mới là yếu tố chi phối định giá. Bài phân tích dưới đây từ Sicomp sẽ đưa ra chi tiết và cung cấp căn cứ để doanh nghiệp quyết định đầu tư chính xác.
I. LỊCH SỬ ĐIỀU CHỈNH GIÁ: TỪ $31/GB LÊN $78/GB TRONG VÒNG MỘT NĂM
Sự xuất hiện của bản 64GB đánh dấu đỉnh điểm của chu kỳ tăng giá bộ nhớ DRAM toàn cầu. Bản 128GB nguyên bản đã trải qua hai đợt điều chỉnh giá niêm yết chính thức:
- Tháng 10/2025: Ra mắt bản 128GB Founders Edition với giá 3.999 USD.
- Tháng 02/2026: Tăng giá đợt 1 lên mức 4.699 USD (+17,5%).
- Tháng 10/2026: Tiếp tục điều chỉnh lên 6.950 USD (tổng mức tăng gần 74% so với thời điểm ra mắt).
- Cùng thời điểm: Bản 64GB mới được định vị ở mức 4.999 USD.
Để thấy rõ mức độ lạm phát phần cứng đối với các nhóm phát triển AI, chúng ta thiết lập công thức tính đơn giá trên mỗi Gigabyte bộ nhớ khả dụng:
| Phiên bản phần cứng | Dung lượng bộ nhớ | Mức giá niêm yết | Chi phí trên mỗi GB |
|---|---|---|---|
| DGX Spark 128GB (Ra mắt) | 128 GB LPDDR5x | 3.999 USD | ~31,24 USD / GB |
| DGX Spark 128GB (Hiện tại) | 128 GB LPDDR5x | 6.950 USD | ~54,30 USD / GB (+73,8%) |
| DGX Spark 64GB (Bản mới) | 64 GB LPDDR5x | 4.999 USD | ~78,11 USD / GB (+150%) |
BẢN CHẤT KINH TẾ CỦA MỨC GIÁ 4.999 USD:
Mặc dù phiên bản 64GB giúp hạ thấp rào cản chi phí vốn ban đầu (CAPEX) thêm khoảng 1.950 USD so với việc mua bản 128GB hiện hành, nhưng xét trên giá trị thực của tài nguyên bộ nhớ, đây là cấu hình có chi phí đắt đỏ nhất trong lịch sử dòng DGX Spark. Khách hàng đang phải trả mức giá cao hơn gấp 2,5 lần cho mỗi Gigabyte bộ nhớ so với những người mua máy ở giai đoạn đầu năm tài khóa.
II. PHẦN CỨNG GIỮ NGUYÊN, BĂNG THÔNG 273 GB/S KHÔNG ĐỔI
Ngoại trừ việc cắt giảm một nửa số lượng chip nhớ LPDDR5x vật lý (hoặc thay đổi mật độ die trên bus 256-bit), toàn bộ kiến trúc tính toán của bản 64GB được giữ nguyên vẹn:
- Siêu chip NVIDIA GB10 Grace Blackwell: Tích hợp 20 nhân CPU Arm (10 nhân Cortex-X925 hiệu năng cao kết hợp 10 nhân Cortex-A725 tiết kiệm điện) cùng khối GPU kiến trúc Blackwell (6.144 nhân CUDA, nhân Tensor Cores thế hệ thứ 5 hỗ trợ FP4/FP8 và nhân RT Cores thế hệ thứ 4).
- Mã lực tính toán AI lý thuyết: Vẫn đạt định mức 1 PFLOPS ở định dạng FP4 Sparse (khoảng ~1.000 TOPS) và hỗ trợ đầy đủ bộ tăng tốc Transformer Engine thế hệ mới.
- Băng thông bộ nhớ hợp nhất: Giữ nguyên ở mức 273 GB/s trên giao diện bus 256-bit. Chuẩn kết nối giữa CPU và GPU là đường liên kết nội bộ NVLink-C2C.
- Hạ tầng giao tiếp mạng cao cấp: Trang bị sẵn card mạng NVIDIA ConnectX-7 SmartNIC 200 Gbps (2 cổng QSFP112) kèm cổng 10GbE RJ-45 LAN độc lập và Wi-Fi 7.
CÔNG THỨC GIỚI HẠN VẬT LÝ CỦA DECODE SPEED:
Trong các bài toán suy luận LLM (Inference), giai đoạn sinh token phụ thuộc hoàn toàn vào băng thông bộ nhớ (Memory Bandwidth), được xác định theo mô hình vật lý:
Vì băng thông bộ nhớ của bản 64GB vẫn bị chặn ở mức 273 GB/s, tốc độ xử lý của từng mô hình cụ thể khi nạp vào máy sẽ không có bất kỳ sự cải thiện nào so với bản 128GB. Giới hạn vật lý duy nhất bị thu hẹp lại chính là: kích thước tối đa của mô hình và độ dài ngữ cảnh (context length) mà hệ thống có thể nạp được.
III. NĂNG LỰC CHẠY MODEL THỰC TẾ: 64GB NẠP ĐƯỢC MÔ HÌNH NÀO?
Trong kiến trúc bộ nhớ thống nhất (Unified Memory), toàn bộ hệ điều hành NVIDIA DGX OS, kernel Linux, các dịch vụ nền và bộ nhớ đệm đồ họa tiêu tốn một khoản dung lượng cố định từ 8GB đến 12GB RAM ngay sau khi khởi động. Do đó, dung lượng bộ nhớ thực tế khả dụng cho tiến trình AI (Model Weights + KV Cache + Activations) trên bản 64GB chỉ còn lại khoảng 52GB đến 56GB.
NVIDIA tuyên bố bản 64GB có thể vận hành các mô hình có quy mô lên tới 100 tỷ tham số (100B). Phân tích kỹ thuật chuyên sâu chỉ ra các điều kiện ràng buộc thực tế:
| Quy mô mô hình | Định dạng tối ưu | Khả năng đáp ứng trên bản 64GB | Đánh giá kỹ thuật thực tế |
|---|---|---|---|
| Mô hình ≤ 30B tham số (Qwen 30B, Llama 8B) | FP16 / BF16 / FP8 | Hoạt động xuất sắc | Dư dả bộ nhớ cho KV Cache ngữ cảnh dài (32k - 128k context) và chạy nhiều luồng đồng thời. |
| Mô hình MoE ~30B (Qwen3:30b-a3b) | FP8 / INT4 | Rất mượt mà (~90 tok/s) | Khai thác tối đa ưu thế kích hoạt từng phần của MoE, tốc độ phản hồi rất cao. |
| Mô hình Dense 70B (Llama 3.1 70B) | Bắt buộc INT4 / FP4 | Chạy rất sát giới hạn | Bản INT4 chiếm khoảng ~40GB. Phần dư ~12GB chỉ đủ cho context ngắn (4k - 8k tokens). Dễ bị OOM nếu mở rộng cửa sổ ngữ cảnh. |
| Mô hình ~100B tham số | Bắt buộc FP4 / INT3 cực hạn | Khả thi trên lý thuyết | Chỉ chạy được ở chế độ đơn luồng (concurrency = 1) với độ chính xác bị suy giảm đáng kể do nén lượng tử hóa sâu. |
IV. 2X 64GB VS 1X 128GB — ĐÁNH ĐỔI GIỮA TỐC ĐỘ VÀ CHI PHÍ
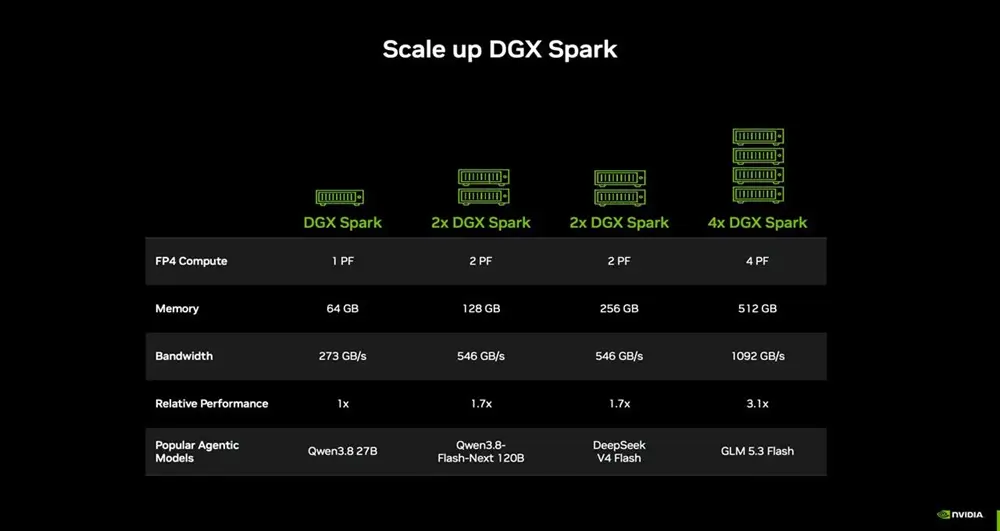
Cùng với việc ra mắt bản 64GB, NVIDIA công bố rằng: Cụm hai máy DGX Spark 64GB ghép lại có thể đạt tốc độ suy luận nhanh hơn một máy 128GB đơn lẻ tới 1,7 lần khi thử nghiệm trên mô hình ngôn ngữ 27B tham số. Bản chất kỹ thuật đằng sau con số này được giải thích như sau:
- Nhân đôi băng thông bộ nhớ tổng hợp: Khi ghép 2 node qua mạng ConnectX-7 200Gbps bằng kỹ thuật song song hóa Tensor Parallelism (TP=2) hoặc Pipeline Parallelism, mô hình 27B được phân chia đều cho hai chip GB10. Lúc này, hệ thống tận dụng đồng thời hai đường bus bộ nhớ 256-bit độc lập, nâng tổng băng thông truy xuất lên: 273 GB/s × 2 = 546 GB/s. Chính băng thông tổng hợp 546 GB/s này giúp tốc độ đọc trọng số tăng vọt, tạo ra mức cải thiện 1,7x so với việc chỉ dùng 1 bus 273 GB/s của máy 128GB đơn lẻ.
- Nhân đôi số lượng nhân tính toán: Cụm 2 máy cung cấp tổng cộng 40 nhân CPU Arm và 2 PFLOPS FP4, tối ưu hóa tốc độ xử lý prompt (Prefill stage).
MẶT TRÁI CỦA PHƯƠNG ÁN GHÉP 2 MÁY 64GB:
Để đổi lấy mức tăng tốc 1,7 lần trên các mô hình vừa và nhỏ, doanh nghiệp phải trả một mức giá rất đắt về mặt chi phí đầu tư:
- Chi phí mua 2 máy DGX Spark 64GB: 4.999 USD × 2 = 9.998 USD (chưa tính chi phí cáp đồng thụ động DAC QSFP112 200G).
- Chi phí mua 1 máy DGX Spark 128GB hiện hành: 6.950 USD.
Kết luận: Doanh nghiệp phải chi thêm hơn 3.000 USD (+43,8% ngân sách) chỉ để sở hữu cùng tổng dung lượng 128GB RAM. Đây là phương thức tốn kém nhất để chạm tới ngưỡng 128GB bộ nhớ.
V. CĂN CỨ ĐỂ RA QUYẾT ĐỊNH: NÊN MUA BẢN NÀO?
Dựa trên các thông số đo đạc thực tế, đội ngũ kỹ sư Sicomp đưa ra khung định hướng lựa chọn rõ ràng cho từng nhóm đối tượng:
| Nhu cầu & Quy mô Workload | Phương án phần cứng đề xuất | Căn cứ kỹ thuật & Tài chính |
|---|---|---|
| Chạy mô hình ≤ 30B tham số, làm môi trường dev cho hệ sinh thái Jetson / Isaac | DGX Spark 64GB ($4.999) | Tiết kiệm gần 2.000 USD tiền mặt so với bản 128GB. 64GB là quá đủ để chạy Llama 8B, Qwen 14B/30B với context đầy đủ. |
| Chạy mô hình 70B–120B tham số (Llama 3 70B, GPT-OSS 120B) với context dài | DGX Spark 128GB ($6.950) | Bắt buộc phải dùng bản 128GB. Bản 64GB sẽ tràn bộ nhớ (OOM) ngay khi cửa sổ ngữ cảnh vượt quá 8k tokens trên model 70B. |
| Cần tổng 128GB RAM nhưng muốn tối ưu chi phí đầu tư | Mua 1 máy 128GB (Tránh ghép 2 máy 64GB) | Mua 1 máy 128GB tiết kiệm hơn 3.000 USD, không phải cấu hình mạng cluster phức tạp, tiêu thụ ít điện hơn. |
| Chỉ cần tốc độ sinh chữ đơn luồng kịch trần trên model ≤ 32B | PC Desktop ráp card RTX 5090 32GB | Băng thông VRAM RTX 5090 đạt tới 1.792 GB/s (nhanh gấp 6,5 lần DGX Spark), giá thành hệ thống rẻ hơn đáng kể. |
VI. KHI BỘ NHỚ TRỞ THÀNH NÚT THẮT CỦA AI
Sự điều chỉnh giá và phân mảnh cấu hình của dòng DGX Spark là minh chứng rõ ràng nhất cho xu hướng lớn: GPU không còn là thứ duy nhất bị thiếu hụt, mà chính chip nhớ mới là tâm điểm của cuộc khủng hoảng phần cứng. Toàn bộ các nhà máy sản xuất wafer bán dẫn hàng đầu (Samsung, SK Hynix, Micron) đang ưu tiên dồn công suất dây chuyền sang đóng gói bộ nhớ HBM3e và HBM4 phục vụ các siêu chip trung tâm dữ liệu như B200 hay H200.
Hệ quả trực tiếp là nguồn cung chip nhớ LPDDR5x và DRAM tiêu chuẩn bị bóp nghẹt. Các trung tâm dữ liệu khổng lồ (Hyperscalers) đang bao tiêu phần lớn sản lượng bộ nhớ toàn cầu, buộc các doanh nghiệp vừa và nhỏ (SMB) cùng các phòng nghiên cứu phải chấp nhận mua các thiết bị tính toán biên với mức giá ngày càng tăng cao.
VII. TỔNG KẾT
NVIDIA DGX Spark 64GB là giải pháp giúp hạ thấp rào cản chi phí gia nhập hệ sinh thái tính toán AI chuẩn mực của NVIDIA xuống mức 4.999 USD. Tuy nhiên, xét trên đơn giá từng Gigabyte ($78/GB) và trần giới hạn ngữ cảnh khi chạy các mô hình 70B, đây là cấu hình đòi hỏi sự tính toán kỹ lưỡng về mặt kỹ thuật phần mềm. Nếu mô hình của bạn cố định dưới 30B tham số, bản 64GB là lựa chọn tối ưu ngân sách; nhưng nếu đích đến là các mô hình 70B–120B với context dài, bản 128GB nguyên bản vẫn là khoản đầu tư kinh tế và an toàn hơn về lâu dài.
Bài viết liên quan
Thị Trường PC Toàn Cầu Q3 2026 Sụt Giảm 20.1%: Áp Lực Tồn Kho Và Giá Linh Kiện
Báo cáo IDC Q3 2026: Sản lượng xuất xưởng PC toàn cầu giảm 20.1% xuống 62.7 triệu máy do dư âm ôm hàng nửa đầu năm và giá phần cứng tăng cao. HP và Dell giảm sâu.
LiquidJet Diamond: Tích Hợp Kim Cương Vào Tấm Làm Mát Tăng 35% Token/Watt Cho Chip AI
Frore Systems ra mắt LiquidJet Diamond tích hợp tấm kim cương cho phiến lạnh AI: giảm nhiệt thêm 10°C, tản điểm nóng tới 770 W/cm2, tăng 35% doanh thu Token/Watt.
Đánh giá Supermicro AOC-S100G-M2C-P: Khi nào nên chọn
Đánh giá card mạng Supermicro AOC-S100G-M2C-P hai cổng 100GbE: trần băng thông PCIe 3.0 x16, lịch hỗ trợ driver ConnectX-4 và khi nào nên chọn.
NVIDIA Ra Mắt DGX Station Chạy Windows: GB300, 748GB Bộ Nhớ, 20 PFLOPs
NVIDIA công bố phiên bản DGX Station chạy Windows trang bị siêu chip GB300 Blackwell Ultra, 20 PFLOPs AI compute, 748GB Unified Memory đối đầu Threadripper Halo Station.