CPU NVIDIA Vera: Tái Sinh Hiệu Năng Đơn Nhân Cho AI
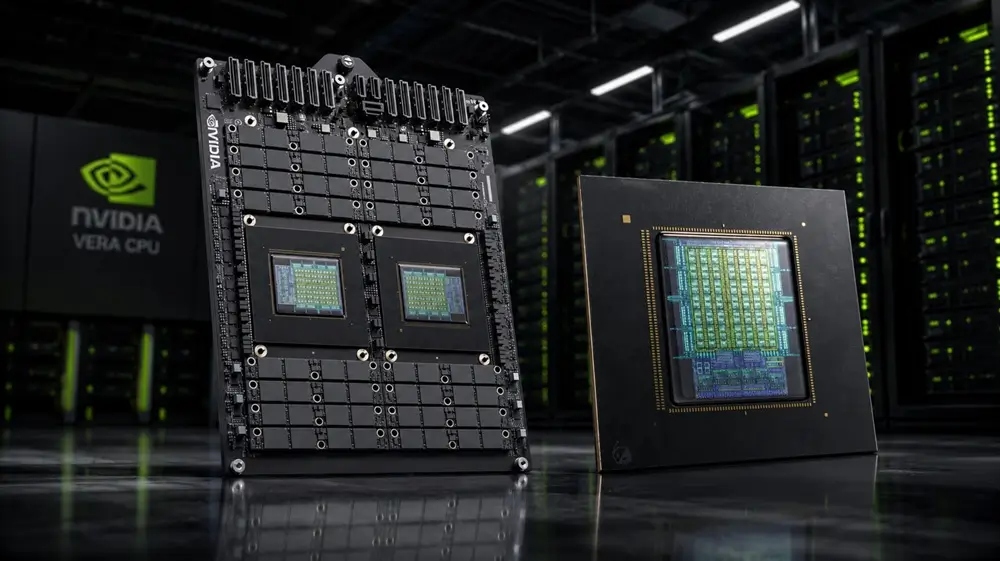
Sự xuất hiện của dòng vi xử lý trung tâm NVIDIA Vera CPU đang đánh dấu một cuộc tái định nghĩa sâu sắc về kiến trúc máy tính trung tâm dữ liệu. Thay vì tiếp tục đóng vai trò là một bộ xử lý đa nhiệm thông thường trong mô hình cô lập tác vụ truyền thống, CPU trong kỷ nguyên mới đang chuyển mình thành một "nhạc trưởng" điều phối chuyên biệt, giải quyết các vòng lặp suy luận phức tạp của hệ thống trí tuệ nhân tạo dạng tác tử (Agentic AI). Trong cuộc phỏng vấn độc quyền gần đây cùng Wccftech, nhóm kỹ sư phát triển Vera của NVIDIA đã tiết lộ một thực tế đáng chú ý: sau nhiều năm hạ tầng điện toán đám mây ưu tiên nhồi nhét số lượng nhân khổng lồ và đánh đổi hiệu năng đơn nhân, chính Agentic AI đang đảo ngược xu hướng này. Cùng Sicomp đi sâu bóc tách những thay đổi mang tính bản lề trong kiến trúc silicon của NVIDIA.
I. TỪ CHẠY ĐUA SỐ NHÂN THỜI KỲ CLOUD SANG SỰ TRỖI DẬY CỦA ĐƠN NHÂN
Vào đầu những năm 2010, thiết kế chip máy chủ tập trung tối đa vào sức mạnh của từng nhân xử lý đơn lẻ thay vì số lượng nhân (điển hình như thế hệ kiến trúc Intel Haswell). Đây là thời kỳ nằm ở góc phần tư "Hiệu năng đơn nhân cao nhưng tổng thông lượng thấp" do số lượng nhân trên một đế bán dẫn còn hạn chế.
Tuy nhiên, khi các nhà cung cấp đám mây quy mô lớn bùng nổ, bài toán kinh tế đòi hỏi các nhà sản xuất phải nhồi nhét càng nhiều nhân vào một máy chủ càng tốt để tối đa hóa doanh thu trên mỗi rack. Để đạt mật độ này và khống chế giá thành, các nhà sản xuất x86 chuyển dịch từ thiết kế vi xử lý nguyên khối sang kiến trúc ghép nối nhiều đế nhỏ. Sự mở rộng ồ ạt về số lượng nhân này phải trả giá bằng sự suy giảm chỉ số lệnh trên mỗi chu kỳ và hiệu năng trên từng nhân: diện tích trên đế silicon không còn đủ không gian vật lý để thiết kế các cụm nhân đơn lẻ siêu mạnh.
Bước ngoặt xảy ra khi Agentic AI xuất hiện. Các tác tử AI không hoạt động theo luồng tĩnh mà vận hành trong một vòng lặp liên tục, chớp nhoáng giữa GPU và CPU. GPU là tài sản đắt đỏ nhất trong các nhà máy AI (AI Factory), và nếu CPU xử lý các tác vụ tuần tự (sequential tasks) chậm chạp, GPU sẽ rơi vào trạng thái "đói dữ liệu" và nhàn rỗi. Do đó, CPU hiện đại bắt buộc phải có hiệu năng đơn nhân cực cao, truy cập bộ nhớ tức thời và triệt tiêu độ trễ.
VỊ THẾ KHÁC BIỆT CỦA NVIDIA VERA
NVIDIA Vera phá vỡ sự đánh đổi lịch sử của kỷ nguyên Cloud bằng cách bước vào vị trí hiếm hoi: Hiệu năng đơn nhân cao kết hợp cùng thông lượng tổng hợp lớn. Con chip đạt được điều này nhờ 3 yếu tố: xung nhịp lõi cao, hệ thống phụ bộ nhớ LPDDR5X tùy biến mang lại băng thông rộng, và một đế tính toán nguyên khối (Monolithic Compute Die) liên kết qua mạng kết nối mạch Scalable Coherent Fabric thế hệ 2.
II. VÌ SAO NVIDIA KIÊN QUYẾT CHỌN ĐẾ NGUYÊN KHỐI MONOLITHIC DIE?
Không giống như các nhà sản xuất x86 truyền thống buộc phải phát triển một kiến trúc linh hoạt dùng chung cho cả thị trường máy tính cá nhân phổ thông lẫn trung tâm dữ liệu, NVIDIA bước vào mảng CPU độc lập mà không bị ràng buộc bởi các phân khúc kế thừa trong quá khứ. Hãng có đặc quyền thiết kế Vera dành riêng cho một mục tiêu duy nhất: Trung tâm dữ liệu AI siêu hiệu năng.
Để đáp ứng các vòng lặp truy xuất dữ liệu liên tục của tác tử AI và phân tích dữ liệu lớn, NVIDIA từ chối xu hướng đa chiplet và kiên định với thiết kế đế nguyên khối:
- Xóa bỏ hoàn toàn thuế giao tiếp I/O: Trên một đế silicon liên tục, nhân xử lý ở góc trên bên trái có thể giao tiếp với nhân ở góc dưới bên phải mà không phải đi qua bất kỳ ranh giới giao tiếp ngoại vi (I/O boundaries) nào, loại bỏ hoàn toàn độ trễ trễ vật lý giữa các die.
- Băng thông mặt cắt liên nhân (Bisection Bandwidth) đạt 3,4 TB/s: Con số này cao gấp 3 lần so với các dòng chip x86 hàng đầu hiện nay, cho phép các nhân xử lý chia sẻ ngữ cảnh (shared context) và cộng tác dữ liệu nhanh hơn gấp 3 lần.
III. SPATIAL MULTITHREADING: CÔNG NGHỆ PHÂN LUỒNG MỚI GIÚP VƯỢT X86 GẤP 2 LẦN
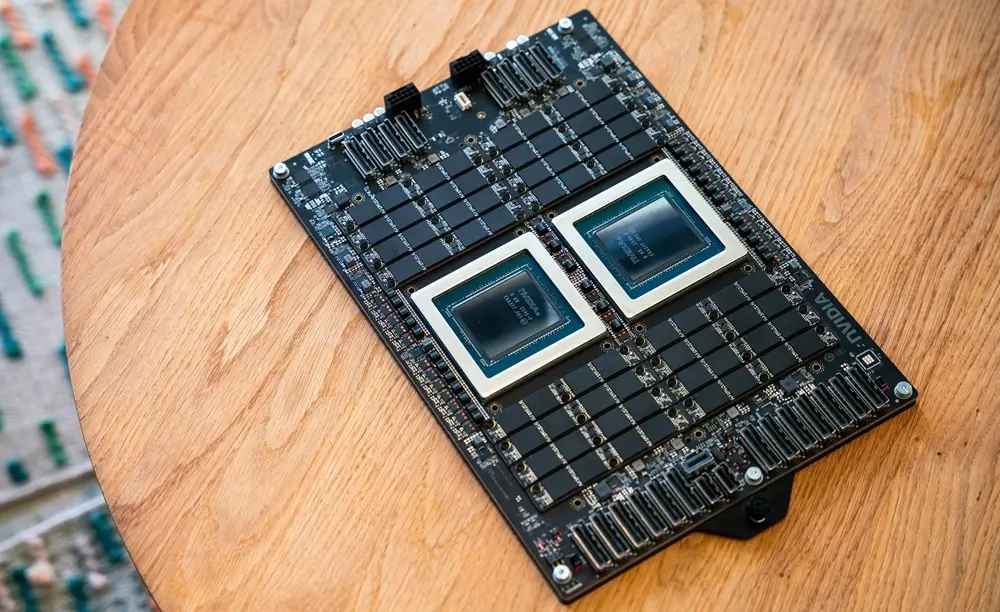
Về sức mạnh xử lý, Vera mang lại bước nhảy vọt khi đạt hiệu năng tổng thể nhanh gấp 1,5 lần so với thế hệ tiền nhiệm Grace. Đáng chú ý, khi đo kiểm trên các khối lượng công việc đặc thù của Agentic AI – vốn phụ thuộc nặng nề vào các tác vụ xử lý tuần tự như mã lệnh Python và biên dịch phần mềm – Vera nhanh hơn tới 2 lần so với các vi xử lý x86 mạnh nhất hiện nay (vượt 1,6 lần tính theo trung bình nhân Geometric Mean).
Thay vì dựa vào kỹ thuật đa luồng đồng thời (SMT) truyền thống, NVIDIA đã triển khai tính năng độc quyền mang tên Spatial Multithreading (Đa luồng không gian):
- Phân chia luồng cứng: Cho phép chỉ định cứng một luồng chuyên trách tính toán chính (Worker thread) và một luồng chuyên trách xuất nhập dữ liệu (I/O thread).
- Không bị "cướp chu kỳ xung": Ngay cả dưới các khối lượng tính toán nặng trên toàn cụm máy chủ, nhân xử lý không bao giờ bị chiếm dụng xung nhịp để phục vụ tác vụ I/O chạy nền, duy trì sự cân bằng tài nguyên hoàn hảo.
- Không phát sinh hao phí hiệu năng: Báo cáo độc lập từ trang tin phần cứng uy tín Phoronix xác nhận công nghệ Spatial Multithreading của NVIDIA trên Vera không tạo ra bất kỳ độ trễ kiến trúc nào, ngược lại còn mang đến mức tăng trưởng hiệu năng thực tế khoảng 20%.
IV. XU HƯỚNG TÁCH RỜI HẠ TẦNG VÀ SỰ BÙNG NỔ CỦA CÁC RACK CPU THUẦN TÚY
Trước đây với vi xử lý Grace, chiến lược ban đầu của NVIDIA là tạo ra nút máy chủ chủ quản (Host Node) tối thượng – đóng vai trò làm cầu nối dữ liệu cho cụm GPU trong tủ rack theo tỷ lệ 1:4 hoặc 1:8. Tuy nhiên, làn sóng Agentic AI và phương pháp học tăng cường (Reinforcement Learning) đã buộc hãng phải chuyển đổi chiến lược.
Giờ đây, các tác tử AI liên tục thực hiện các lệnh gọi công cụ (Tool Calls) và chạy môi trường giả lập thử nghiệm (Sandboxes). Nhiều nhà cung cấp hạ tầng hiện đang vận hành tới 400.000 môi trường sandbox độc lập cho chỉ một khách hàng duy nhất. Nhu cầu xử lý hàng nghìn tỷ lượt tương tác này đã thúc đẩy NVIDIA thương mại hóa Vera như một dòng CPU độc lập, dẫn đến sự ra đời của các tủ rack thuần CPU (Pure CPU Racks) chuyên biệt chỉ để giải quyết khối lượng suy luận tuần tự khổng lồ trước khi đẩy kết quả ngược lại cho GPU.
V. GÓC NHÌN KỸ THUẬT TỪ SICOMP: CHUẨN BỊ HẠ TẦNG CHO MÔ HÌNH TÁC TỬ
Thông điệp từ kiến trúc NVIDIA Vera mang lại bài học hạ tầng sâu sắc cho các doanh nghiệp và studio công nghệ tại Việt Nam đang có định hướng phát triển AI Agents:
- Đừng chỉ dồn toàn bộ ngân sách vào GPU: Trong các hệ thống chạy tác tử AI, nếu trang bị card đồ họa cực mạnh nhưng CPU có xung nhịp đơn nhân thấp hoặc băng thông RAM hạn chế, hệ thống sẽ liên tục nghẽn cổ chai tại các bước gọi API, xử lý kịch bản Python và truy vấn cơ sở dữ liệu vector.
- Cân bằng tỷ lệ CPU/GPU: Tỷ lệ tài nguyên phần cứng đang dịch chuyển rõ rệt. Một hệ thống máy trạm AI lý tưởng cần trang bị các dòng CPU có IPC xuất sắc, xung nhịp đơn nhân cao và hỗ trợ băng thông RAM lớn để giải phóng tối đa sức mạnh của dàn GPU.
- Đầu tư giải pháp chuyên dụng: Doanh nghiệp có thể tham khảo các dòng máy tính cấu hình cao tại danh mục PC AI hoặc các giải pháp máy trạm chuyên sâu cho xử lý mô hình lớn tại PC Server & Workstation được đo kiểm tối ưu tại Sicomp.
Bài viết liên quan
Excel chạy chậm, Not Responding: sửa file hay đổi máy?
Đo thời gian tính, kiểm Excel 32-bit hay 64-bit, dọn công thức và file, rồi tính RAM và CPU cần có. Quy trình từng bước để quyết định sửa file hay đổi máy.
After Effects báo thiếu bộ nhớ: nguyên nhân, cách xử lý
Phân loại thông báo thiếu bộ nhớ của After Effects, tính dung lượng khung hình, kiểm RAM dùng chung với Premiere và mức RAM nên có cho máy dựng motion 2026.
Module Quang Marvell Đặt Bộ Nhớ Cách GPU 50m
Marvell ra mắt Photonic Fabric Memory Module: Đặt bộ nhớ HBM và DDR cách GPU 50m qua kết nối quang, giải bài toán Memory Wall cho AI.
AMD Rò Rỉ Ryzen AI 7 HX 455: 8 Nhân Với iGPU 16 CU
Rò rỉ AMD Ryzen AI 7 HX 455 (Gorgon Point): 8 nhân 16 luồng, 24MB L3 Cache, tích hợp iGPU Radeon 890M 16 CU nhân đôi đồ họa được Sicomp phân tích kỹ thuật.