AI TOP 100 B850 RTX 5090 32GB chạy được mô hình AI nào?
Nhìn vào bảng giới thiệu với các thông số ấn tượng như suy luận mô hình 235 tỷ tham số hay tinh chỉnh mô hình 110B, không ít người lầm tưởng AI TOP 100 B850 trang bị RTX 5090 32GB có thể vận hành trọn vẹn mọi tác vụ AI hiện nay. Thế nhưng, khi đưa vào môi trường làm việc thực chiến với các tệp dữ liệu nặng và yêu cầu đọc hiểu văn bản dài, liệu 32GB VRAM thế hệ mới có thực sự đủ sức? Điểm giới hạn nào sẽ khiến cỗ máy này bắt đầu chạm trần bộ nhớ? Hãy cùng đội ngũ kỹ thuật của Sicomp kiểm chứng chi tiết qua từng kích thước mô hình cụ thể ngay dưới đây.
I. RTX 5090 32GB TRONG AI TOP 100 CHẠY ĐƯỢC MÔ HÌNH CỠ NÀO?
Theo thông tin từ trang chủ NVIDIA, card đồ họa RTX 5090 sở hữu 32 GB bộ nhớ GDDR7, mức dung lượng này đủ đáp ứng cho các mô hình ngôn ngữ có kích thước lên đến 32 tỷ tham số ở mức định lượng từ 4-bit đến 6-bit, hoặc các kiến trúc chuyên gia kết hợp quy mô khoảng 20 đến 30 tỷ tham số. Bảng dưới đây đối chiếu kích thước các tệp định dạng GGUF được ghi nhận trực tiếp trên Hugging Face (dữ liệu truy xuất ngày 14/10/2026), trong đó kích thước tệp phản ánh sát phần trọng số mô hình cần nạp vào VRAM (chưa bao gồm bộ nhớ đệm ngữ cảnh):
| Mô hình và mức nén | Dung lượng file GGUF | Khả năng nằm gọn trong 32GB |
|---|---|---|
| gpt-oss-20b MXFP4 | 12,11 GB | Có, dư nhiều chỗ cho ngữ cảnh |
| Gemma 3 27B QAT Q4_0 | 17,23 GB | Có |
| Qwen3-30B-A3B Q4_K_M | 18,56 GB | Có |
| Qwen3-32B (Q4_K_M / Q6_K / Q8_0) | 19,76 / 26,88 / 34,82 GB | Có / Sát trần / Không |
| Llama 3.3 70B (Q4_K_M / IQ2_M) | 42,52 / 24,12 GB | Không / Có (nhưng nén sâu 2-bit) |
| gpt-oss-120b MXFP4 | 63,39 GB | Không |
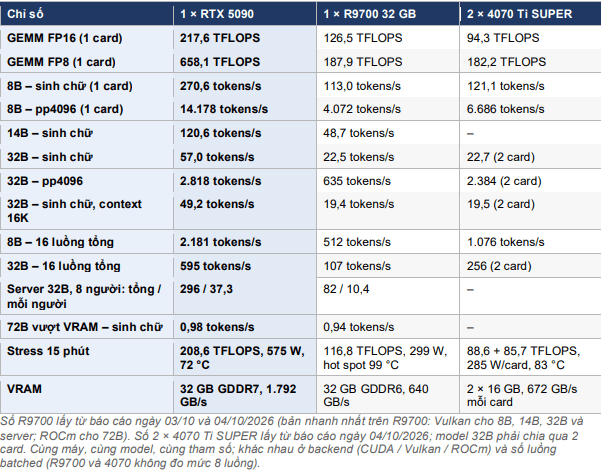
Thông số do Google công bố ngày 18/04/2025 hoàn toàn khớp với bảng dữ liệu trên: mô hình Gemma 3 27B khi chuyển đổi từ dạng chuẩn BF16 (54 GB) xuống định dạng int4 đã rút gọn xuống 14,1 GB, và Google cũng nêu rõ con số này mới chỉ tính riêng phần trọng số tĩnh. Ranh giới vận hành thực tế của cấu hình RTX 5090 32GB nằm ở nhóm mô hình 32B nén 4-bit. Dưới đây cũng là kết quả Sicomp test RTX 5090, R9700 và 2 x RTX 4070 Ti Super để khách hàng có cái nhìn tổng quát nhất.
II. NGỮ CẢNH DÀI TỐN THÊM BAO NHIÊU VRAM?
Với mô hình dense như Qwen3-32B, mỗi token trong cửa sổ ngữ cảnh sẽ tiêu tốn thêm 256 KiB VRAM để duy trì bộ nhớ đệm KV Cache. Khi đẩy cửa sổ ngữ cảnh lên 32.768 token, riêng phần đệm này đã chiếm dụng tới 8,59 GB VRAM.
Con số trên được tính toán trực tiếp từ file cấu hình kiến trúc của Qwen3-32B (gồm 64 lớp, 8 đầu key/value, mỗi đầu có độ dài 128 chiều):
| Mức nén của mô hình | Ngữ cảnh 8.192 token (+2,15 GB) | Ngữ cảnh 32.768 token (+8,59 GB) |
|---|---|---|
| Q4_K_M (19,76 GB trọng số) | 21,91 GB | 28,35 GB (vẫn vừa 32GB) |
| Q6_K (26,88 GB trọng số) | 29,03 GB | 35,47 GB (vượt trần 32GB) |
Ngược lại, mô hình MoE như Qwen3-30B-A3B nhẹ hơn đáng kể ở khoản này: cấu trúc gồm 48 lớp và 4 đầu key/value, giúp mỗi token chỉ tốn 98.304 byte bộ nhớ đệm. Nhờ đó, việc mở rộng đến 32.768 token chỉ làm phát sinh thêm 3,22 GB VRAM. Nếu dự án của doanh nghiệp đòi hỏi truy vấn và đọc hiểu tài liệu văn bản dài, cấu trúc MoE sẽ giải phóng nhiều không gian đệm hơn hẳn so với bản dense 32B.
QUAN ĐIỂM CỦA SICOMP
Trên card 32GB, hãy ưu tiên chọn mức nén Q4_K_M thay vì Q6_K cho mô hình dense 32B khi cần cửa sổ ngữ cảnh trên 8.000 token. Căn cứ thực tế là ở mốc 32.768 token, bản Q6_K sẽ bị tràn VRAM (35,47 GB), trong khi bản Q4_K_M chỉ chiếm 28,35 GB và vẫn để lại khoảng 3,65 GB cho các thành phần runtime của hệ thống.
III. CON SỐ 65 TOKEN/GIÂY CỦA GIGABYTE NÓI LÊN ĐIỀU GÌ?
Con số tốc độ 65 token/giây là kết quả thử nghiệm nội bộ của hãng Gigabyte khi chạy mô hình Qwen3 32B ở định dạng FP4 trên bo mạch chủ B850 đi cùng card RTX 5090 (theo chú thích trang sản phẩm ghi nhận ngày 14/10/2026). Gigabyte có ghi rõ lưu ý: "Dựa trên thử nghiệm nội bộ của GIGABYTE. Hiệu năng thực tế có thể thay đổi" và hiện chưa có bài đo độc lập của bên thứ ba cho riêng cấu hình này.
Bên cạnh đó, hai mốc thông số khác cần được lưu ý phân biệt rõ ràng:
- Mốc suy luận 235B: Hãng thử nghiệm chạy mô hình Qwen3-235B-A22B FP4 trên phiên bản lắp hai card đồ họa AMD Radeon AI PRO R9700, không phải năng lực xử lý của một card RTX 5090.
- Mốc "110B fine-tune model size": Hãng không công bố chú thích cấu hình phần cứng cụ thể đi kèm.
Người dùng cấu hình RTX 5090 không nên lấy hai chỉ số trên làm thước đo cho dự án của mình. Tốc độ sinh chữ thực tế còn bị chi phối bởi framework vận hành (llama.cpp, vLLM, Ollama), chiều dài prompt đầu vào và số lượng truy vấn đồng thời. Giải pháp chắc chắn nhất là chạy kiểm thử thực tế trên chính mô hình và tập dữ liệu của bạn trước khi đưa ra quyết định.
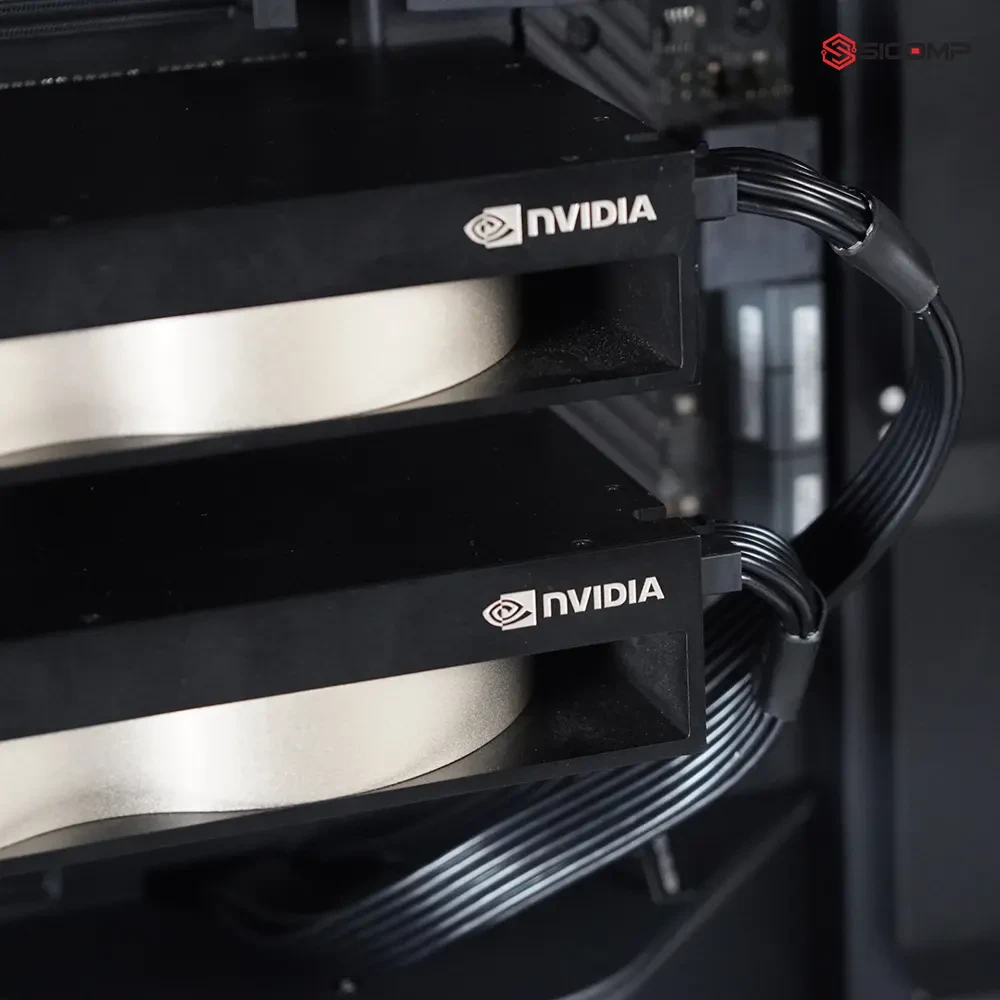
MÁY TRẠM GIGABYTE AI TOP 100 B850 (AT1A9N9-5100)
Cấu hình trang bị AMD Ryzen 9 9950X, NVIDIA GeForce RTX 5090 32GB, 128GB DDR5: lựa chọn tối ưu cho nhóm kỹ sư triển khai các mô hình AI dưới 32 tỷ tham số nén 4-bit.
IV. MÔ HÌNH LỚN HƠN 32GB THÌ 128GB RAM GIÚP ĐƯỢC GÌ?
Dung lượng 128GB RAM hệ thống cho phép cỗ máy nạp được những mô hình có kích thước vượt quá giới hạn 32GB VRAM bằng giải pháp phân bổ một phần layers sang cho CPU tính toán (ví dụ như mô hình gpt-oss-120b nặng 63,39 GB). Tuy nhiên, phần tác vụ chuyển giao cho CPU sẽ có tốc độ chậm hơn rất nhiều so với GPU, và hiệu năng tổng thể lúc này phụ thuộc hoàn toàn vào băng thông truyền tải của RAM.
Băng thông bộ nhớ của máy có một giới hạn kỹ thuật quan trọng: Theo đặc tả của AMD, bộ vi xử lý Ryzen 9 9950X hỗ trợ 2 kênh bộ nhớ, đạt tốc độ DDR5-5600 khi cắm 2 thanh RAM, nhưng khi cắm đủ cả 4 thanh RAM thì tốc độ chính thức hạ xuống mức DDR5-3600. Do cấu hình máy 128GB bằng 4 thanh 32GB, băng thông lý thuyết của RAM sẽ thấp hơn 36% so với khi chạy cấu hình 2 thanh (mức 3.600 MT/s so với 5.600 MT/s).
Hệ thống vẫn hỗ trợ mở rộng tối đa lên 256GB RAM theo công bố từ AMD và Gigabyte. Tuy nhiên, để nâng cấp lên mức này, người dùng sẽ phải thay thế toàn bộ 4 thanh cũ bằng 4 thanh dung lượng 64GB do toàn bộ 4 khe cắm trên bo mạch đều đã được sử dụng.
V. FINE-TUNE TRÊN MÁY GIGABYTE AI TOP LÀM ĐƯỢC ĐẾN ĐÂU?
Quá trình Fine-tuning trên hệ thống này vận hành dựa trên phần mềm GIGABYTE AI TOP Utility. Tiện ích này áp dụng kỹ thuật "memory offloading" để luân chuyển một phần dữ liệu huấn luyện nặng từ VRAM và RAM sang lưu trữ tạm thời trên ổ cứng SSD. SSD AI TOP 100E 2TB sở hữu TBW cao gấp 150 lần so với ổ SSD thông thường, cùng tốc độ đọc ghi tuần tự đạt 7.000 / 5.900 MB/s.
Cần hiểu đúng bản chất kỹ thuật: Dù SSD NVMe có tốc độ đọc ghi cao đến đâu thì vẫn chậm hơn băng thông VRAM hàng chục lần. Vì vậy, cơ chế offload sang SSD là giải pháp giúp hệ thống chạy được những mô hình vượt dung lượng bộ nhớ chứ không giúp mô hình chạy nhanh.
Khi đặt mua thiết bị, doanh nghiệp cần xác nhận rõ ràng với đơn vị bán hàng xem ổ cứng đi kèm có đúng là mã AI TOP 100E hay không, bởi trang thông số của hãng chỉ ghi chung là "2TB SSD". Nếu cấu hình sử dụng ổ Gen4 thông thường, chu kỳ ghi xóa liên tục trong quá trình huấn luyện AI sẽ làm hao mòn tuổi thọ ổ đĩa nhanh hơn đáng kể.
VI. KHI NÀO 32GB KHÔNG CÒN ĐỦ?
Dung lượng 32GB VRAM sẽ bắt đầu chạm ngưỡng giới hạn khi nhóm phát triển yêu cầu vận hành mô hình 70B ở mức nén 4-bit trở lên, hoặc chạy các mô hình 32B ở mức định lượng 8-bit. Khi đó, người dùng có ba phương án mở rộng phần cứng với sự khác biệt rõ rệt về hệ sinh thái và năng lực xử lý:
| Phương án phần cứng | Không gian VRAM | Ưu điểm vận hành | Rào cản kỹ thuật cần lưu ý |
|---|---|---|---|
| Bản B850 hai card Radeon AI PRO R9700 (AT1A9A7-5101) | 2 × 32 GB GDDR6 | Mô hình Llama 3.3 70B Q4_K_M (42,52 GB) có thể phân bổ đều trên hai card. | Hệ thống phần mềm của nhóm bắt buộc phải tương thích và chạy ổn định trên nền tảng AMD ROCm. |
| Máy trạm một card RTX PRO 6000 Blackwell | 96 GB GDDR7 ECC | Mô hình 70B nằm trọn vẹn trên 1 card duy nhất, giữ nguyên hệ sinh thái CUDA. | Bản Workstation Edition tiêu thụ 600W, đòi hỏi hệ thống nguồn và tản nhiệt công suất lớn. |
| Giữ nguyên RTX 5090, kích hoạt offload sang RAM | 32 GB + RAM | Tận dụng phần cứng sẵn có, không phát sinh chi phí đầu tư thêm. | Tốc độ ở các lớp chạy CPU bị chậm; 4 thanh RAM bị giới hạn ở DDR5-3600. |
Thông số kỹ thuật của card R9700 được trích từ trang chủ AMD (32 GB GDDR6 mỗi card, công suất 300 W), trong khi thông số dòng RTX PRO 6000 căn cứ theo công bố của NVIDIA. Nếu dự án của doanh nghiệp đã chuẩn hóa theo hệ sinh thái CUDA và bắt buộc triển khai mô hình 70B cục bộ, giải pháp card đồ họa chuyên dụng Leadtek NVIDIA RTX PRO 6000 Blackwell Max-Q 96GB là phương án nâng cấp tiếp theo rất đáng để cân nhắc.
VII. CẦN ĐẶT RA NHỮNG CÂU HỎI GÌ TRƯỚC KHI MUA?
Để đảm bảo cỗ máy đáp ứng trọn vẹn nhu cầu nghiên cứu và vận hành thực tế, người mua nên trao đổi kỹ với nhà cung cấp qua 4 câu hỏi trọng tâm sau:
- Ổ cứng 2TB kèm máy là dòng AI TOP 100E chuyên dụng hay là ổ SSD PCIe Gen4 thông thường?
- Hệ thống 4 thanh RAM thực tế đang nhận ở tốc độ bus nào trong BIOS, và hệ thống có đang kích hoạt cấu hình EXPO hay không?
- Đơn vị bán hàng có hỗ trợ nạp chạy thử nghiệm trực tiếp mô hình và độ dài prompt đặc thù của nhóm trước khi bàn giao máy không?
- Chính sách bảo hành được tính theo gói nguyên bộ hay từng linh kiện rời, quy trình xử lý tại chỗ hay phải gửi máy về hãng?
Nếu mô hình của bạn nằm trong phạm vi tương thích ở bảng mục đầu, cấu hình Gigabyte AI TOP 100 B850 bản RTX 5090 hoàn toàn đáp ứng tốt nhu cầu. Trường hợp cần chạy mô hình 70B ngay từ đầu, hãy so sánh kỹ giữa phiên bản 2 card R9700 và giải pháp máy trạm RTX PRO 6000. Nếu chưa xác định chắc chắn quy mô mô hình cần dùng, việc chạy thử nghiệm trên phần cứng hiện có hoặc thuê dịch vụ đám mây ngắn hạn trước khi chốt cấu hình sẽ giúp tối ưu ngân sách tốt nhất.
*Ghi chú kỹ thuật: Các thông số trong bài được trích xuất từ tài liệu công bố chính thức của Gigabyte, AMD, NVIDIA và nền tảng Hugging Face tại thời điểm ngày 14/10/2026; hiệu năng thực tế phụ thuộc vào cấu hình cụ thể và ngăn xếp phần mềm triển khai. Số liệu tốc độ của Gigabyte dựa trên kết quả kiểm nghiệm nội bộ của hãng.
Bài viết liên quan
Excel chạy chậm, Not Responding: sửa file hay đổi máy?
Đo thời gian tính, kiểm Excel 32-bit hay 64-bit, dọn công thức và file, rồi tính RAM và CPU cần có. Quy trình từng bước để quyết định sửa file hay đổi máy.
After Effects báo thiếu bộ nhớ: nguyên nhân, cách xử lý
Phân loại thông báo thiếu bộ nhớ của After Effects, tính dung lượng khung hình, kiểm RAM dùng chung với Premiere và mức RAM nên có cho máy dựng motion 2026.
Module Quang Marvell Đặt Bộ Nhớ Cách GPU 50m
Marvell ra mắt Photonic Fabric Memory Module: Đặt bộ nhớ HBM và DDR cách GPU 50m qua kết nối quang, giải bài toán Memory Wall cho AI.
AMD Rò Rỉ Ryzen AI 7 HX 455: 8 Nhân Với iGPU 16 CU
Rò rỉ AMD Ryzen AI 7 HX 455 (Gorgon Point): 8 nhân 16 luồng, 24MB L3 Cache, tích hợp iGPU Radeon 890M 16 CU nhân đôi đồ họa được Sicomp phân tích kỹ thuật.