NVIDIA Ra Mắt Nemotron 3.5: Đột Phá AI Agent Local 24GB VRAM
NVIDIA đang chứng minh tham vọng áp đảo mảng mô hình trí tuệ nhân tạo trọng số mở (Open-weight Models), đặc biệt sau bước đi chiến lược đạt thỏa thuận thâu tóm nền tảng Hugging Face. Không để cộng đồng công nghệ phải chờ đợi lâu, đội xanh vừa chính thức công bố bộ ba mô hình AI thế hệ mới thuộc hệ sinh thái Nemotron 3.5, tập trung tối ưu hóa chuyên sâu cho các hệ thống tác tử tự hành: Nemotron 3.5 Super VL 120B cho hạ tầng tác tử doanh nghiệp, Nemotron 3.5 Bolt 74B-A9B cho các tác vụ Agentic cục bộ chỉ với 24GB VRAM, và Nemotron 3.5 Bolt E4B siêu nhẹ gói gọn trong 4GB VRAM. Cùng Sicomp đi sâu phân tích kiến trúc phần cứng và khả năng ứng dụng thực tế của đợt ra mắt chấn động này.
I. NEMOTRON 3.5 SUPER VL 120B: TÁC TỬ ĐA PHƯƠNG THỨC DOANH NGHIỆP NHANH GẤP 5 LẦN
Đứng đầu đợt công bố là Nemotron 3.5 Super VL – mô hình đa phương thức trọng số mở quy mô 120 tỷ tham số, được thiết kế chuyên biệt để đóng vai trò "bộ não" điều phối cho các hệ thống tác tử vận hành liên tục 24/7 (Always-on Agents). Theo tuyên bố từ NVIDIA, mô hình đạt độ chính xác dẫn đầu trong các tác vụ tác tử phức tạp như: tuân thủ chỉ dẫn nhiều bước, tự động gọi công cụ, đọc hiểu thị giác và xử lý quy trình kinh doanh nhiều tầng.
Những đột phá công nghệ cốt lõi trên Nemotron 3.5 Super VL bao gồm:
- Năng lực ngang ngửa mô hình suy luận lớn nhất với 1/5 kích thước: Đạt hiệu năng tương đương các mô hình Reasoning khổng lồ của NVIDIA nhưng tham số chỉ bằng khoảng 20%, giúp giảm áp lực hạ tầng đáng kể.
- Tốc độ sinh tác tử nhanh gấp 5 lần đối thủ: Được định danh là mô hình tác tử trọng số mở có tốc độ xử lý nhanh nhất phân khúc, rút ngắn thời gian xử lý các luồng công việc quy mô lớn của doanh nghiệp.
- Đọc hiểu tài liệu thị giác trực tiếp (Visual Document Comprehension): Khả năng nhận diện quang học (OCR), đọc biểu đồ, bảng biểu phức tạp trong file PDF hay trang web mà không cần phải định tuyến qua các hệ thống OCR tách rời bên ngoài.
- Được huấn luyện trên tập dữ liệu khổng lồ: Mô hình được train sẵn trên hơn 25 nghìn tỷ (25 Trillion) token và tinh chỉnh qua 4 triệu mẫu dữ liệu hậu huấn luyện (Post-training samples), cung cấp đầy đủ trọng số mở, tập dữ liệu và công thức huấn luyện (Training recipes) để doanh nghiệp tự Fine-tune nội bộ.
II. NEMOTRON 3.5 BOLT 74B-A9B: CHẠY AGENT LOCAL VỪA GỌN 24GB VRAM
Tâm điểm chú ý của cộng đồng phát triển Local AI chính là Nemotron 3.5 Bolt 74B-A9B. Đây là mô hình dạng lai chuyên gia (Hybrid Mixture-of-Experts – MoE) có tổng cộng 74 tỷ tham số, nhưng chỉ kích hoạt 9 tỷ tham số tại mỗi thời điểm suy luận.
BƯỚC ĐỘT PHÁ CỦA ĐỊNH DẠNG NÉN 2-BIT: VỪA VẶN MỘT CARD ĐỒ HỌA ĐƠN LẺ
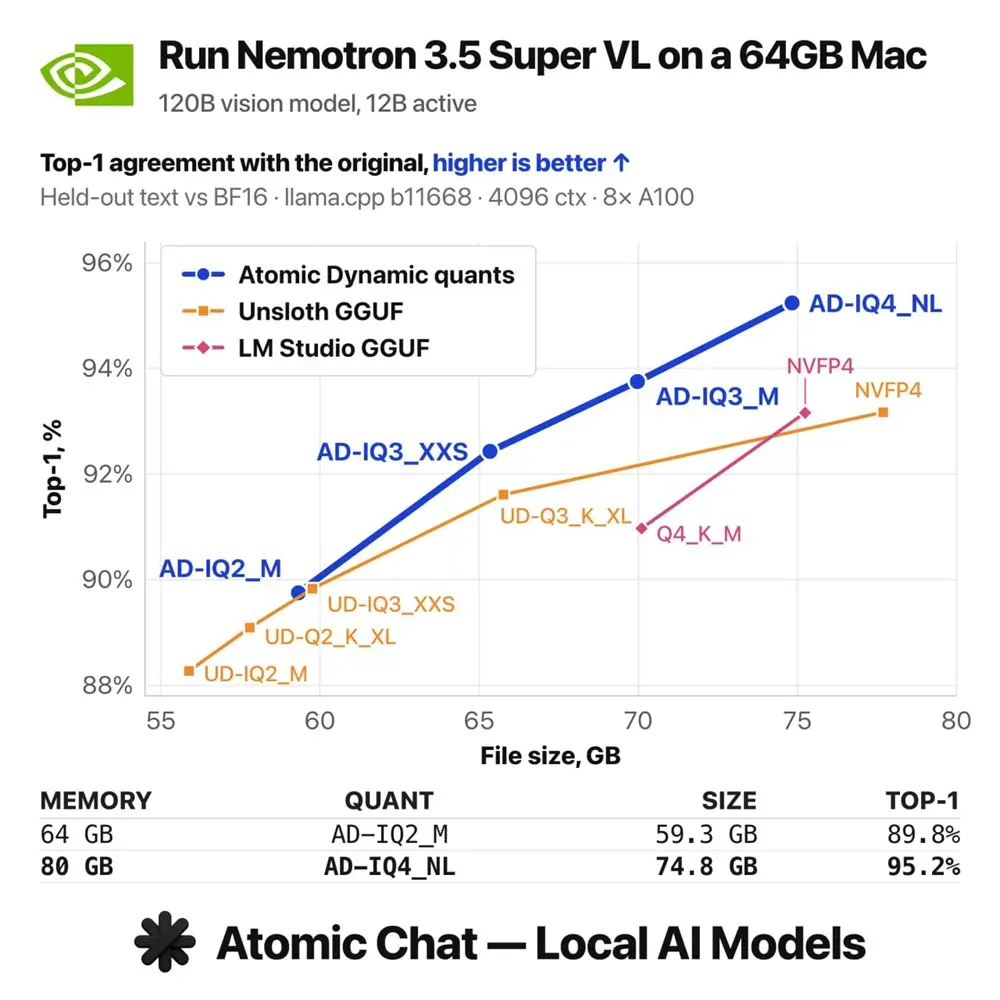
Nhờ áp dụng kỹ thuật định lượng cực sâu 2-bit quantization, Nemotron 3.5 Bolt 74B-A9B được nén gọn gàng vào dung lượng bộ nhớ 24GB VRAM. Điều này giải quyết triệt để rào cản chi phí: bạn hoàn toàn có thể chạy mượt mà một mô hình tác tử MoE 74B trên các cấu hình máy tính cá nhân hoặc máy trạm trang bị 1 card đơn lẻ sở hữu 24GB VRAM như GeForce RTX 3090, RTX 4090 hay RTX 5090 mà không cần đầu tư hệ thống Multi-GPU đắt đỏ.
Với Nemotron 3.5 Bolt 74B-A9B, các kỹ sư và lập trình viên có thể giao phó hoàn toàn các tác vụ nhạy cảm như duyệt web, phân tích linh kiện PC, viết mã nguồn và gỡ lỗi (debug code) đa bước ngay trên máy tính cục bộ mà không để rò rỉ bất kỳ byte dữ liệu nào lên môi trường Cloud. Mô hình tương thích hoàn hảo với các framework phổ biến như vLLM, Ollama, LM Studio và llama.cpp trên Hugging Face.
III. NEMOTRON 3.5 BOLT E4B: TÁC TỬ HỘI THOẠI SIÊU NHẸ GÓI GỌN TRONG 4GB VRAM
Mảnh ghép thứ ba trong đợt ra mắt là Nemotron 3.5 Bolt E4B – mô hình Edge tí hon với dung lượng chỉ chiếm 4 GB bộ nhớ. Phiên bản này được tối ưu hóa đặc biệt cho các tác tử giao tiếp vật lý và hội thoại thời gian thực (Physical and Conversational Agents).
Với yêu cầu phần cứng siêu thấp, Bolt E4B có thể khởi chạy mượt mà trên các dòng card đồ họa phổ thông GeForce RTX, các thiết bị nhúng NVIDIA Jetson hay máy tính cá nhân. Mô hình xuất sắc trong việc duy trì hội thoại tự nhiên nhiều lượt, kết hợp gọi công cụ ngoại vi, tuân thủ trạng thái ứng dụng – biến nó thành giải pháp hoàn hảo để tích hợp vào các giao diện điều khiển giọng nói, nhân vật ảo tương tác trong game và thiết bị IoT thông minh.
IV. KIẾN TRÚC HYBRID MAMBA-TRANSFORMER: LỜI GIẢI CHO BÀI TOÁN TỐC ĐỘ TÁC TỬ
Vào tháng 8 vừa qua, NVIDIA từng giới thiệu mô hình Nemotron 3.5 Lightning với khả năng sinh token nhanh gấp 4 lần các mô hình cùng quy mô. Tuy nhiên, tốc độ sinh từ trên lý thuyết này chỉ giúp tăng tốc độ hoàn thành công việc thực tế của tác tử (Agentic tasks) thêm vỏn vẹn 30%. Nghĩa là mô hình xả token cực nhanh nhưng hiệu quả điều phối chuỗi hành động lại bị suy giảm biên độ.
Để khắc phục triệt để điểm nghẽn này, dòng Nemotron 3.5 mới đã kế thừa và hoàn thiện cấu trúc lai sâu sắc từ Lightning:
- Kiến trúc lai Hybrid Mamba-Transformer: Kết hợp khả năng ghi nhớ ngữ cảnh dài tuyến tính của Mamba State Space Models với năng lực xử lý chiều sâu của Transformer.
- Dự đoán đa token (Multi-token Prediction): Cho phép mô hình dự đoán nhiều token cùng lúc thay vì sinh tuần tự từng từ một, đẩy nhanh tốc độ phản hồi.
- Cấu trúc MoE ẩn & Suy luận suy đoán (Speculative Decoding): Tận dụng các chuyên gia mạng nơ-ron chuyên biệt để đưa ra phản hồi logic với độ trễ thấp nhất.
V. BẢNG SO SÁNH THÔNG SỐ VÀ CẤU HÌNH PHẦN CỨNG ĐỀ XUẤT TẠI SICOMP
Dưới đây là bảng tổng hợp các thông số kỹ thuật cốt lõi của bộ ba mô hình Nemotron 3.5 cùng khuyến nghị cấu hình phần cứng tối ưu từ Sicomp:
| Tên mô hình AI | Quy mô tham số | Mức VRAM yêu cầu | Phần cứng máy tính đề xuất |
|---|---|---|---|
| Nemotron 3.5 Bolt E4B | Dòng Edge siêu nhỏ | Khoảng 4 GB VRAM | Các dòng PC sử dụng card GeForce RTX 3060, RTX 4060 hoặc kit nhúng NVIDIA Jetson. |
| Nemotron 3.5 Bolt 74B-A9B | 74B MoE (Kích hoạt 9B) | 24 GB VRAM (2-bit) | Cấu hình máy trạm Deskside 1 card đồ họa 24GB như RTX 3090, RTX 4090 hoặc RTX 5090. |
| Nemotron 3.5 Super VL | 120B Multimodal Dense | Từ 80 GB – 128 GB+ VRAM | Hạ tầng máy trạm Multi-GPU chuyên dụng, NVIDIA DGX Spark, hoặc các trạm PC Server & Workstation đa card. |
VI. TƯ VẤN TRIỂN KHAI HẠ TẦNG CHẠY MÔ HÌNH AI CỤC BỘ TẠI SICOMP
Việc NVIDIA tối ưu hóa thành công mô hình 74B nén 2-bit để chạy vừa vặn trên 24GB VRAM là tin vui cực lớn cho các studio, doanh nghiệp vừa và nhỏ muốn bảo mật tuyệt đối dữ liệu nội bộ mà không cần phụ thuộc vào API đắt đỏ của bên thứ ba. Bạn hoàn toàn có thể tự xây dựng một hệ thống tác tử AI thông minh ngay tại văn phòng với chi phí đầu tư ban đầu hợp lý.
Sicomp chuyên cung cấp và thiết kế theo yêu cầu các cấu hình máy tính cá nhân mạnh mẽ, dàn PC Gaming cao cấp trang bị VRAM lớn và các dòng máy trạm tính toán AI chuyên dụng. Đội ngũ kỹ thuật viên của Sicomp luôn sẵn sàng hỗ trợ cài đặt sẵn môi trường chạy mô hình AI (vLLM, Ollama, LM Studio, Docker) và đo kiểm tải thực tế trước khi bàn giao máy.
Bài viết liên quan
Excel chạy chậm, Not Responding: sửa file hay đổi máy?
Đo thời gian tính, kiểm Excel 32-bit hay 64-bit, dọn công thức và file, rồi tính RAM và CPU cần có. Quy trình từng bước để quyết định sửa file hay đổi máy.
After Effects báo thiếu bộ nhớ: nguyên nhân, cách xử lý
Phân loại thông báo thiếu bộ nhớ của After Effects, tính dung lượng khung hình, kiểm RAM dùng chung với Premiere và mức RAM nên có cho máy dựng motion 2026.
Module Quang Marvell Đặt Bộ Nhớ Cách GPU 50m
Marvell ra mắt Photonic Fabric Memory Module: Đặt bộ nhớ HBM và DDR cách GPU 50m qua kết nối quang, giải bài toán Memory Wall cho AI.
AMD Rò Rỉ Ryzen AI 7 HX 455: 8 Nhân Với iGPU 16 CU
Rò rỉ AMD Ryzen AI 7 HX 455 (Gorgon Point): 8 nhân 16 luồng, 24MB L3 Cache, tích hợp iGPU Radeon 890M 16 CU nhân đôi đồ họa được Sicomp phân tích kỹ thuật.