
Máy Tính Chạy Ollama Cần Cấu Hình Gì?
Nhu cầu triển khai LLM nội bộ thông qua framework mã nguồn mở Ollama đang trở thành xu hướng phổ biến tại các doanh nghiệp và nhóm nghiên cứu nhằm bảo vệ tính riêng tư của dữ liệu. Khác với việc gọi API đám mây, AI Local đòi hỏi phần cứng máy tính phải trực tiếp gánh vác việc nạp trọng số mô hình và duy trì bộ đệm ngữ cảnh. Sai lầm phổ biến của nhiều người dùng là tập trung nâng cấp CPU đắt tiền nhưng lại chọn card không đủ dung lượng bộ nhớ, dẫn đến hiện tượng tràn VRAM và khiến tốc độ phản hồi tụt xuống mức không thể sử dụng. Sicomp sẽ giải thích cơ chế cấp phát tài nguyên của Ollama, VRAM theo từng kích thước mô hình và đưa ra hướng dẫn lựa chọn linh kiện phù hợp với từng nhu cầu thực tế.
I. Cơ chế phân bổ bộ nhớ của Ollama khi chạy mô hình ngôn ngữ lớn
Về mặt kiến trúc phần mềm, Ollama sử dụng lõi tính toán nền tảng từ dự án mã nguồn mở llama.cpp, vận hành dựa trên định dạng tệp GGUF. Khi người dùng khởi chạy một mô hình (ví dụ qua lệnh ollama run llama3.3), phần mềm sẽ cố gắng nạp toàn bộ các layers của mô hình vào VRAM của VGA.
Tốc độ xử lý thực tế sẽ phụ thuộc vào việc mô hình có nằm trọn vẹn trong VRAM hay không:
- Trường hợp toàn bộ mô hình nằm trọn trong VRAM: GPU sẽ đảm nhận toàn bộ quá trình xử lý ma trận thông qua các nhân CUDA và băng thông bộ nhớ đồ họa cực cao (thường từ 500 GB/s đến hơn 1.000 GB/s trên các dòng card GDDR6X/GDDR7). Tốc độ sinh chữ (token generation) lúc này đạt mức tối đa, mang lại trải nghiệm phản hồi mượt mà theo thời gian thực.
- Trường hợp tràn VRAM phải san sang RAM hệ thống: Nếu dung lượng mô hình vượt quá không gian VRAM khả dụng, Ollama sẽ tự động giữ lại một phần layer trên VRAM và đẩy các layer còn lại sang bộ nhớ RAM hệ thống để CPU xử lý. Lúc này, tốc độ sinh chữ sẽ bị kéo tụt nghiêm trọng do băng thông RAM hệ thống (DDR4/DDR5 thường chỉ dao động từ 40 GB/s đến 80 GB/s trên bo mạch chủ phổ thông) chậm hơn VRAM của card đồ họa từ 10 đến 20 lần, đồng thời phát sinh độ trễ truyền tải qua khe cắm PCIe.
- Trường hợp chạy hoàn toàn bằng CPU và RAM: Xảy ra khi máy tính không có card đồ họa rời tương thích. Tốc độ sinh chữ lúc này thường giảm xuống dưới 3 – 5 token/giây trên các mô hình trung bình, chỉ phù hợp để thử nghiệm cú pháp lệnh đơn giản chứ không đáp ứng được nhu cầu công việc thực tế.
II. Bảng tra cứu VRAM theo từng kích thước mô hình AI phổ biến
Phần lớn các mô hình mặc định trên thư viện của Ollama được cung cấp ở mức nén định lượng 4-bit (chủ yếu là chuẩn Q4_K_M). Đây là mức nén cân bằng hài hòa giữa độ chính xác suy luận và mức độ tiêu thụ tài nguyên. Bảng dưới đây đối chiếu dung lượng tệp trọng số tĩnh và mức VRAM tối thiểu khuyến nghị để vận hành mượt mà với cửa sổ ngữ cảnh cơ bản 4.096 token:
| Quy mô mô hình | Các đại diện tiêu biểu | Dung lượng file (Q4_K_M) | Khuyến nghị phần cứng GPU |
|---|---|---|---|
| Nhóm nhỏ (7B – 8B) | Llama 3.1 8B, Qwen 2.5 7B, Mistral 7B, Gemma 2 9B | Khoảng 4,5 – 5,8 GB | Tối thiểu 8GB VRAM (khuyên dùng card 12GB như RTX 3060 12GB để dư cho ngữ cảnh) |
| Nhóm tầm trung (14B) | Qwen 2.5 14B, DeepSeek-R1-Distill-Qwen-14B | Khoảng 9,0 – 9,8 GB | Cần tối thiểu 12GB VRAM (khuyên dùng card 16GB VRAM như RTX 5060 Ti 16GB hoặc RTX 5070 Ti) |
| Nhóm bán chuyên (27B – 32B) | Qwen 2.5 32B, Gemma 2 27B, DeepSeek-R1 32B | Khoảng 17,5 – 20,2 GB | Bắt buộc phải có 24GB VRAM (như RTX 3090, RTX 4090) hoặc 32GB VRAM (RTX 5090) |
| Nhóm quy mô lớn (70B) | Llama 3.3 70B, Qwen 2.5 72B, DeepSeek-R1 70B | Khoảng 42,5 – 45,0 GB | Cần từ 48GB VRAM trở lên (cấu hình chạy song song 2 card 24GB/32GB hoặc máy trạm đơn card RTX PRO 6000 96GB) |
Quan điểm từ Sicomp:
Khi đầu tư cấu hình cho Ollama, mốc 16GB VRAM hiện được xem là ngưỡng tiêu chuẩn hợp lý cho người dùng cá nhân và lập trình viên. Mức dung lượng này cho phép nạp trọn vẹn mô hình 14B – quy mô vừa đủ thông minh để thực hiện tốt các tác vụ viết code, tóm tắt văn bản tiếng Việt – đồng thời vẫn còn khoảng trống bộ nhớ để mở rộng cửa sổ ngữ cảnh mà không bị tràn VRAM.
III. Vì sao cửa sổ ngữ cảnh dài làm phình VRAM đột biến?
Một hiểu lầm rất thường gặp là cho rằng một chiếc card 12GB VRAM chỉ cần nạp mô hình nặng 9GB là sẽ vận hành an toàn. Trong thực tế, ngoài dung lượng lưu trữ trọng số tĩnh, quá trình suy luận của mô hình còn tiêu tốn một lượng bộ nhớ đáng kể cho bộ đệm ngữ cảnh KV Cache.
Mỗi khi người dùng tải vào một đoạn tài liệu dài hoặc duy trì đoạn hội thoại liên tục, lượng token đầu vào sẽ tích lũy trong KV Cache. Mức tiêu tốn bộ nhớ đệm này được tính toán trực tiếp từ các tham số cấu trúc của mô hình:
Lấy ví dụ cụ thể với mô hình dense như Qwen 2.5 32B (sở hữu 64 lớp, 8 đầu key/value, kích thước chiều 128, lưu ở định dạng FP16 chiếm 2 byte): mỗi token sẽ ngốn thêm đúng 262.144 byte (tương đương 256 KiB) bộ nhớ đồ họa:
- Ở ngữ cảnh cơ bản 4.096 token: KV Cache chỉ chiếm khoảng 1,07 GB VRAM.
- Khi mở rộng ngữ cảnh lên 16.384 token: KV Cache sẽ chiếm dụng thêm 4,29 GB VRAM.
- Khi đẩy ngữ cảnh lên mức tài liệu dài 32.768 token: riêng phần đệm KV Cache đã phình to tới 8,59 GB VRAM.
Nếu một mô hình 32B nén 4-bit vốn đã chiếm khoảng 19,8 GB trọng số tĩnh, việc mở rộng cửa sổ ngữ cảnh lên 32k token sẽ đẩy tổng mức chiếm dụng lên tới 28,39 GB VRAM. Con số này sẽ làm tràn hoàn toàn chiếc card 24GB và chỉ có thể vận hành ổn định trên các cấu hình card đồ họa sở hữu từ 32GB VRAM trở lên.
IV. Nên chọn card đồ họa rời NVIDIA CUDA hay bộ nhớ RAM hợp nhất?
Trên thị trường hiện nay có hai trường phái phần cứng phổ biến để vận hành Ollama, mỗi phương án đều có những ưu điểm và rào cản kỹ thuật riêng:
| Tiêu chí kỹ thuật | Hệ thống GPU rời NVIDIA (CUDA Core) | Kiến trúc bộ nhớ hợp nhất |
|---|---|---|
| Tốc độ sinh chữ (Inference) | Rất nhanh (40 – 100+ token/giây) nhờ nhân tensor và băng thông GDDR6X/GDDR7 cao | Ở mức trung bình khá (15 – 30 token/giây) do chia sẻ băng thông bộ nhớ chung |
| Khả năng nạp mô hình lớn | Bị giới hạn bởi mức VRAM vật lý của từng card (8GB, 12GB, 16GB, 24GB, 32GB) | Rất linh hoạt, có thể cấp phát tới 70% – 80% RAM hệ thống (dễ dàng nạp mô hình 70B với chi phí vừa phải) |
| Tương thích phần mềm | Được hỗ trợ tối ưu trên mọi thư viện AI, vLLM, TensorRT-LLM, PyTorch | Chủ yếu vận hành qua backend Metal hoặc ROCm/Vulkan tùy nền tảng |
| Khả năng nâng cấp phần cứng | Dễ dàng cắm thêm card đồ họa thứ hai qua khe PCIe để chạy mô hình lớn hơn | Bộ nhớ thường được hàn chết trên bo mạch, không thể nâng cấp sau khi mua |
Đối với môi trường làm việc doanh nghiệp yêu cầu tốc độ phản hồi nhanh, phục vụ đồng thời nhiều người dùng qua giao tiếp API hoặc có Fine-tuning mô hình trong tương lai, hệ thống máy tính trang bị card đồ họa rời NVIDIA hỗ trợ hệ sinh thái CUDA vẫn là lựa chọn an toàn và ổn định hơn cả.
V. Các cấu hình máy tính chạy Ollama tiêu biểu theo nhu cầu tại Sicomp
Dựa trên các bài đo kiểm thực tế tại phòng kỹ thuật, Sicomp xây dựng 4 phân cấp cấu hình tối ưu phục vụ từ nhu cầu học tập cá nhân cho đến trạm tính toán AI chuyên dụng:
- Cấu hình 1 – Nhập môn chạy mô hình 7B – 8B: Trang bị CPU Intel Core i5-13400F, 32GB RAM DDR4 và card đồ họa NVIDIA GeForce RTX 3060 12GB. Dung lượng 12GB VRAM bảo đảm nạp trọn vẹn Llama 3.1 8B hoặc Qwen 2.5 7B với tốc độ đạt từ 45 đến 60 token/giây.
- Cấu hình 2 – Bán chuyên chạy mô hình 14B: Trang bị CPU AMD Ryzen 7 7700X hoặc Intel Core i7, Ultra 7 cùng 32- 64GB RAM DDR5 và card đồ họa GeForce RTX 5070 Ti 16GB. Mức VRAM 16GB cho phép vận hành mượt mà mô hình 14B với độ dài ngữ cảnh lên tới 16.000 token.
- Cấu hình 3 – Chuyên sâu chạy mô hình 32B: Trang bị CPU AMD Ryzen 9 9900X, 64GB – 128GB RAM DDR5 và card đồ họa RTX 5090 32GB. Cấu hình này đáp ứng hoàn hảo mô hình Qwen 2.5 32B phục vụ các bài toán phân tích logic và hỗ trợ lập trình chuyên sâu.
- Cấu hình 4 – Máy trạm doanh nghiệp chạy mô hình 70B: Sử dụng bo mạch chủ máy trạm hỗ trợ nhiều khe PCIe x16, vi xử lý AMD Ryzen Threadripper PRO hoặc Intel Xeon W, trang bị Dual RTX 5090 hoặc lựa chọn 2 x R9700. Đây là các cấu hình chuẩn cho các phòng máy chủ cục bộ cần triển khai trợ lý ảo cho toàn bộ nhân sự công ty.
VI. Những lưu ý kỹ thuật giúp tối ưu tốc độ sinh chữ khi chạy Ollama
Để khai thác hiệu quả tài nguyên phần cứng sẵn có, người dùng nên lưu ý một số tinh chỉnh kỹ thuật quan trọng trong quá trình vận hành:
- Lựa chọn đúng mức lượng tử hóa: Nếu VRAM bị thiếu hụt nhẹ, hãy ưu tiên tải bản nén Q4_K_M thay vì các bản nặng như Q8_0 hay FP16. Mức hao hụt độ thông minh giữa 4-bit và 8-bit trong các tác vụ thông thường là không đáng kể so với việc tốc độ sinh chữ tăng lên gấp đôi.
- Kiểm soát số lượng layer nạp vào GPU qua file Modelfile: Người dùng có thể chủ động khống chế số lượng layer chuyển giao vào GPU bằng tham số
PARAMETER num_gpu [số_lượng_layer]để dành riêng một khoảng trống VRAM cố định cho hệ điều hành và các ứng dụng màn hình hiển thị. - Giới hạn cửa sổ ngữ cảnh vừa đủ với nhu cầu: Mặc định nhiều mô hình thiết lập ngữ cảnh lên tới 32k hoặc 128k token. Nếu phiên làm việc của bạn chỉ thuần hỏi đáp ngắn dưới dạng hội thoại, hãy chủ động giới hạn tham số
num_ctx 4096hoặc8192để tiết kiệm vài Gigabyte VRAM cho hệ thống. - Trang bị ổ cứng SSD NVMe tốc độ đọc cao: Việc nạp tệp mô hình dung lượng từ 10GB đến 40GB từ ổ cứng lên VRAM mỗi khi khởi chạy dịch vụ sẽ diễn ra trong vòng 2 – 3 giây nếu máy tính sử dụng ổ cứng SSD chuẩn PCIe Gen4 hoặc Gen5, thay vì phải chờ đợi gần một phút nếu dùng các dòng ổ cứng SATA truyền thống.
Bài viết liên quan
MIG Và Ảo Hóa GPU Trên NVIDIA Blackwell Là Gì?
Tìm hiểu công nghệ MIG và vGPU trên dòng NVIDIA Blackwell từ GeForce RTX 5090 đến RTX PRO 6000 Server Edition: Cách chia 1 GPU cho 4–48 người dùng
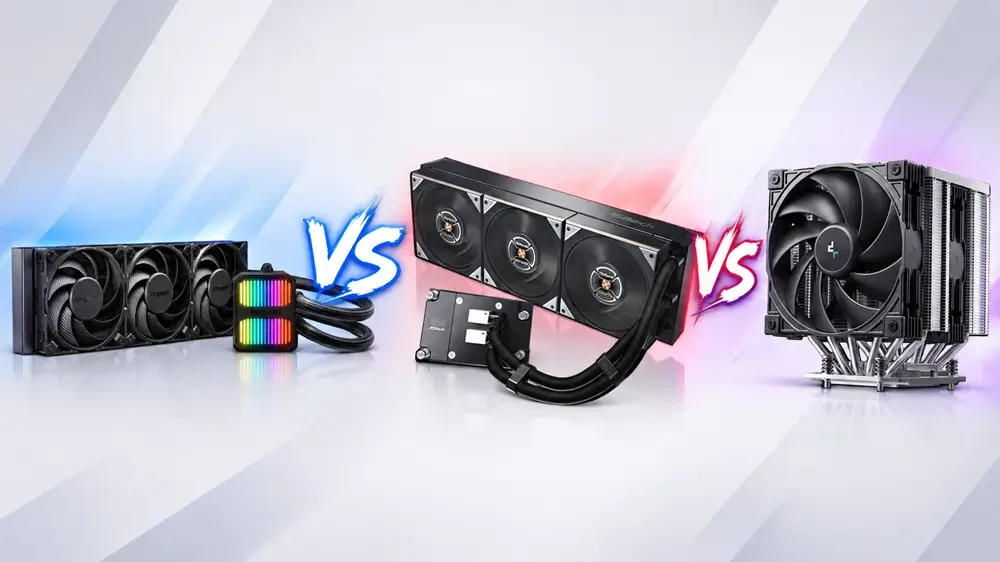
So Sánh 3 Loại Tản Nhiệt Cho Threadripper PRO 9965WX
Thử nghiệm thực tế 3 tản nhiệt be quiet! Silent Loop 3 360, ASRock WS TR 360D và DeepCool StationX 622 trên Threadripper PRO 9965WX qua 9 kịch bản tải tại Sicomp.
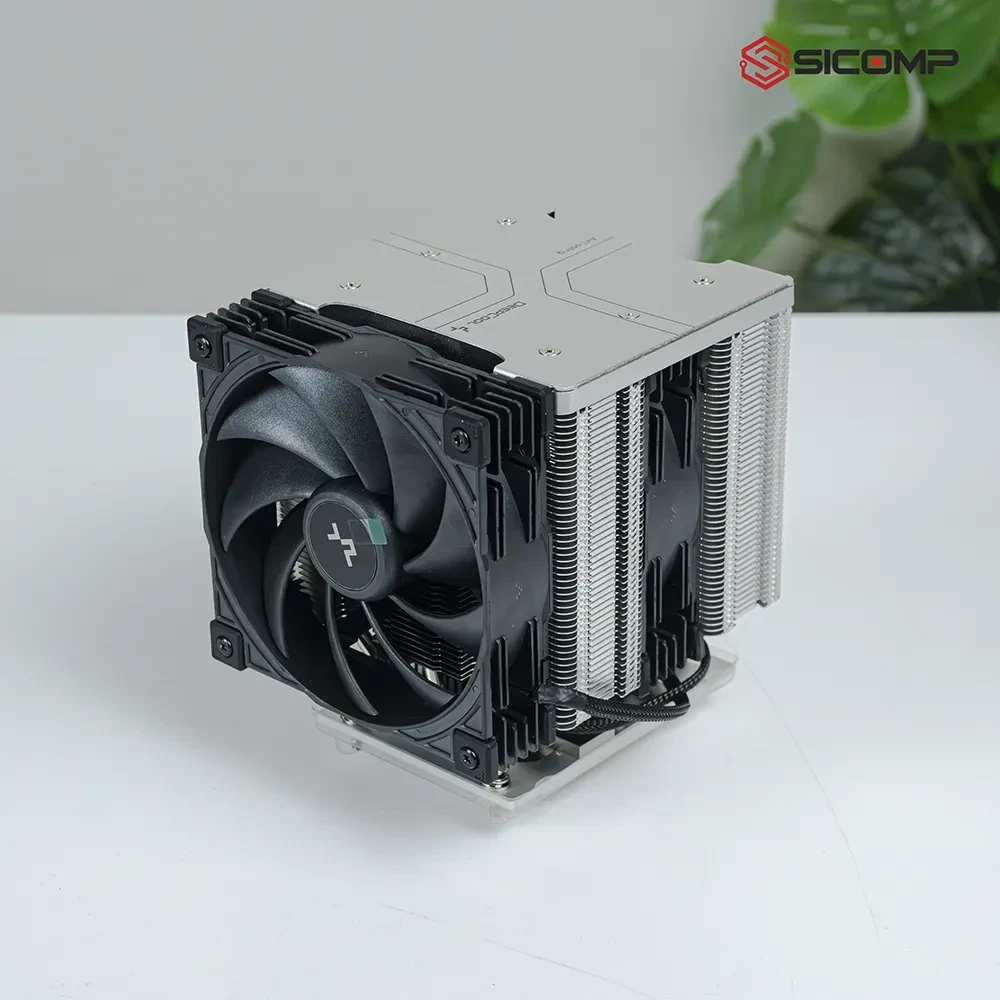
Đánh Giá Hiệu Năng Tản Nhiệt Khí DeepCool StationX 622
Thử nghiệm tản nhiệt khí DeepCool StationX 622 trên Threadripper PRO 9965WX: Đạt 59.526 điểm Cinebench R23 ở mức 300W (77,1°C) và 59.511 điểm ở mặc định 350W tại Sicomp.
Đánh Giá Hiệu Năng Tản Nhiệt ASRock WS TR 360D
Thử nghiệm tản nhiệt nước AIO ASRock WS TR 360D trên Threadripper PRO 9965WX: Đạt 60.210 điểm Cinebench R23 ở 350W (79°C) và cực mát 67,8°C ở mức 300W tại Sicomp.