Intel Ra Mắt D270: GPU AI 480GB Gánh Mô Hình 1.000 Tỷ
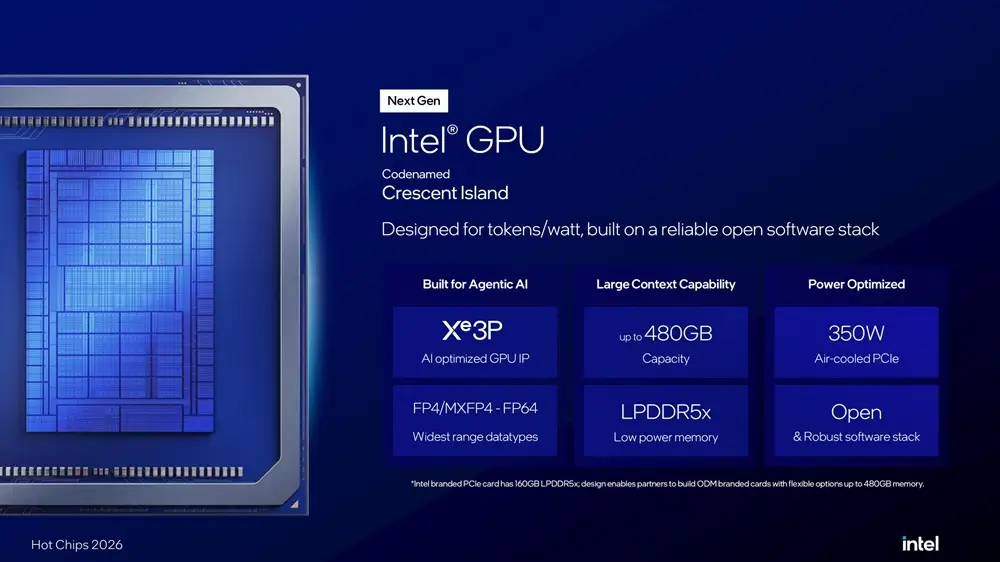
Intel vừa chính thức trình làng dải vi xử lý tăng tốc trí tuệ nhân tạo chuyên dụng thế hệ mới dành cho trung tâm dữ liệu mang tên GPU D-Series (tên mã phát triển nội bộ Crescent Island), phát triển trên kiến trúc vi mô Xe3P. Đại diện đầu tiên của dòng sản phẩm là Intel GPU D270 – card tăng tốc được thiết kế chuyên biệt cho bài toán suy luận AI thay vì đồ họa 3D truyền thống. Với sức mạnh tính toán 1.3 PFLOPs FP8 nhưng chỉ tiêu thụ 350W điện năng qua tản nhiệt khí, cùng tùy chọn bộ nhớ LPDDR5X lên tới 480GB, thiết bị cho phép chạy các mô hình ngôn ngữ lớn tới hàng nghìn tỷ tham số ngay trên hạ tầng PC Workstation tiêu chuẩn mà không cần tới hệ thống tản nhiệt nước phức tạp tại Sicomp.
I. BỘ NHỚ LPDDR5X GIẢI BÀI TOÁN KHAN HIẾM HBM
Trong khi các đối thủ như NVIDIA và AMD đang dồn nguồn lực vào bộ nhớ HBM3e và HBM4 đắt đỏ trên kiến trúc Vera Rubin hay AMD Instinct MI450X, nhu cầu thị trường bùng nổ đã đẩy chuỗi cung ứng HBM rơi vào tình trạng khan hiếm và đẩy chi phí đầu tư lên mức kỷ lục. Intel đã chọn một hướng tiếp cận giàu tính thực tế hơn: tối ưu hóa dung lượng bộ nhớ khả dụng và hạ thấp chi phí triển khai cho các khối lượng công việc suy luận.
Đối chiếu dung lượng bộ nhớ khả dụng trên một thẻ tăng tốc AI giữa các nền tảng:
- Intel Crescent Island (D270): Tối đa lên tới 480 GB LPDDR5X (Bản tiêu chuẩn của Intel trang bị 160GB; các đối tác ODM có thể tùy biến mở rộng lên tới 480GB).
- AMD Instinct MI450X: Tối đa 432 GB HBM4.
- NVIDIA Vera Rubin: Tối đa 288 GB HBM4.
Việc chuyển sang bộ nhớ LPDDR5X với băng thông đạt 1.5 TB/s giúp cắt giảm mạnh giá thành sản xuất thẻ, đồng thời giữ mức công suất định mức chỉ ở ngưỡng 350W trên chuẩn giao tiếp PCIe 5.0 x16. Nhờ đó, các trung tâm dữ liệu có thể lắp đặt trực tiếp vào hệ thống tủ rack làm mát bằng không khí sẵn có mà không phải cải tạo phòng máy.
II. CẮT BỎ ĐỒ HỌA 3D VÀ RAY TRACING ĐỂ DỒN LỰC CHO AI
Kiến trúc vi mô đồ họa thế hệ thứ 3 mang tên Xe3P trên Crescent Island là phiên bản mở rộng từ nền tảng Xe3 trên vi xử lý Panther Lake. Đáng chú ý, để tối ưu hóa hiệu quả tính toán, Intel đã loại bỏ hoàn toàn các khối phần cứng đồ họa 3D truyền thống và các nhân Ray Tracing chuyên dụng. Dù mang danh nghĩa là kiến trúc GPU, D270 không phải là card đồ họa chơi game hay xuất hình, mà toàn bộ diện tích đế silicon được giải phóng để dành riêng cho các khối tính toán ma trận và vector AI:
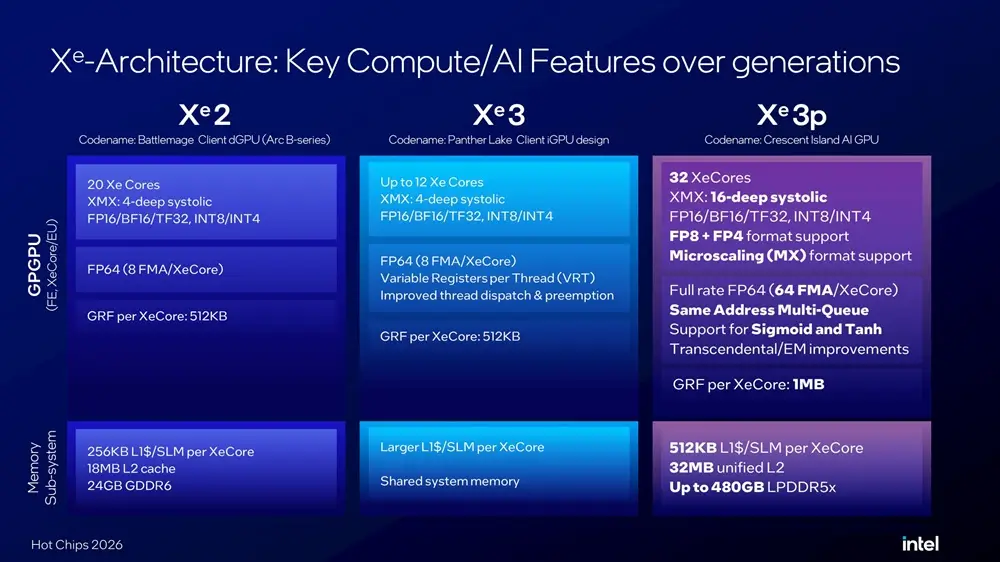
- Quy mô phân bổ nhân: Chip được tổ chức thành 4 cụm phân vùng tính toán (Compute Slices), mỗi slice chứa 8 nhân Xe3P Core. Tổng thể card sở hữu 32 nhân Xe3P, tích hợp 256 Vector Engines và 256 bộ tăng tốc ma trận XMX (Xe Matrix Extensions).
- Hỗ trợ đa định dạng tính toán: Bộ xử lý Vector hỗ trợ từ định dạng độ chính xác thấp FP4, FP8, phát lệnh 3 hướng (3-way co-issue), mở rộng thuật toán toán học cho đến tính toán dấu phẩy động kép FP64 toàn tốc độ (64 FMA/XeCore). Đơn vị XMX vận hành mảng tâm thu (systolic array) độ sâu 16 tầng.
- Hệ thống phân tầng bộ đệm: Mỗi nhân Xe3P trang bị 512 KB bộ nhớ đệm L1/SLM (tổng 16 MB L1), 1 MB thanh ghi GRD trên mỗi core và kết nối vào cụm Unified L2 Cache dung lượng 32 MB, giảm thiểu nghẽn truy xuất ra bộ nhớ LPDDR5X.
III. BẢNG SO SÁNH: INTEL D270 VS CÁC ĐỐI THỦ TRÊN THỊ TRƯỜNG
Sức mạnh tính toán 1.3 PFLOPs ở mức tiêu thụ điện 350W đặt Intel D270 vào vị thế cạnh tranh trực tiếp với các dòng card chuyên dụng dùng khe PCIe của NVIDIA và AMD:
| Dòng card / GPU | Hiệu năng đỉnh FP8 | Công suất TDP | Bộ nhớ & Chuẩn RAM | Băng thông bộ nhớ | Phương thức tản nhiệt |
|---|---|---|---|---|---|
| Intel D270 (Crescent Island) | ~1.3 PFLOPs | 350 W | 160GB (Ref) / Tới 480GB (LPDDR5X) | ~1.5 TB/s (LPDDR5X-9600) | Tản khí thụ động |
| AMD Radeon AI PRO R9700 | 766 TFLOPs (Sparse) | 300 W | 32 GB GDDR6 | 640 GB/s | Tản khí thụ động |
| NVIDIA RTX PRO 5500 Blackwell | ~846 TFLOPs (Dense) | 600 W | 84 GB GDDR7 ECC | ~1.4 TB/s | Tản khí thụ động |
| NVIDIA RTX PRO 5000 Blackwell | ~500 – 550 TFLOPs | 300 W | 48 / 72 GB GDDR7 ECC | ~1.34 TB/s | Tản khí thụ động |
| AMD Instinct MI350P | 2.3 PFLOPs (MXFP8) | 600 W (450W config) | 144 GB HBM3E | 4.0 TB/s | Tản khí thụ động |
IV. LỢI THẾ TCO: GÁNH MÔ HÌNH TỚI 1.000 TỶ THAM SỐ VÀ TỐI ƯU KV CACHE
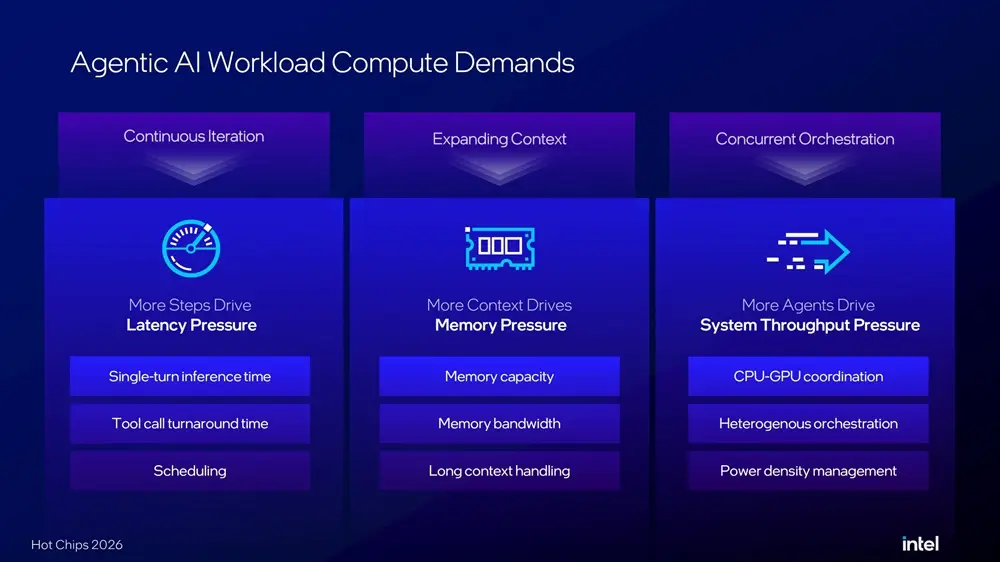
Trong các cụm máy chủ phục vụ mô hình ngôn ngữ lớn, nút thắt lớn nhất thường không nằm ở năng lực tính toán thô mà là bộ nhớ VRAM không đủ lớn để lưu trữ trọng số mô hình cùng không gian đệm KV Cache khi xử lý các chuỗi hội thoại dài hoặc phục vụ nhiều yêu cầu đồng thời.
KHẢ NĂNG XỬ LÝ MÔ HÌNH THỰC TẾ CỦA INTEL GPU D270:
Nhờ không gian bộ nhớ LPDDR5X khổng lồ lên đến 480GB trên một phiến card, Intel D270 mang lại bước nhảy vọt về mật độ triển khai:
- Trên một thẻ GPU đơn lẻ: Có thể chứa trọn vẹn và suy luận các mô hình AI có quy mô lên tới xấp xỉ 300 tỷ tham số (~300B parameters) mà không cần phân mảnh mô hình sang card thứ hai.
- Trên một khung máy chủ 8 GPU: Cung cấp tới gần 3,8 TB dung lượng bộ nhớ hợp nhất, đủ năng lực gánh mượt mà các siêu mô hình ngôn ngữ vượt ngưỡng 1.000 tỷ tham số (>1 Trillion parameters).
*Card đặc biệt tối ưu cho các kịch bản thực tế của doanh nghiệp: Hệ thống đa tác tử, trợ lý doanh nghiệp, trợ lý lập trình, đọc hiểu tài liệu chuyên sâu, mô hình đa phương thức và mô hình khuếch tán hình ảnh.
Ông Anil Nanduri, Phó Chủ tịch kiêm Giám đốc mảng Sản phẩm AI & GTM thuộc Intel Data Center Group khẳng định: "Suy luận đang trở thành khối lượng công việc định hình kỷ nguyên AI, và các doanh nghiệp đòi hỏi cơ sở hạ tầng mang lại hiệu năng tối ưu trên một mức chi phí hợp lý. Với dòng Intel GPU D-series, chúng tôi tập trung biến việc triển khai suy luận dung lượng cao trở nên dễ dàng và đạt hiệu quả kinh tế rõ rệt khi mở rộng quy mô."
V. HỆ SINH THÁI PHẦN MỀM MÃ NGUỒN MỞ VÀ TIẾN ĐỘ THỬ NGHIỆM THỰC TẾ
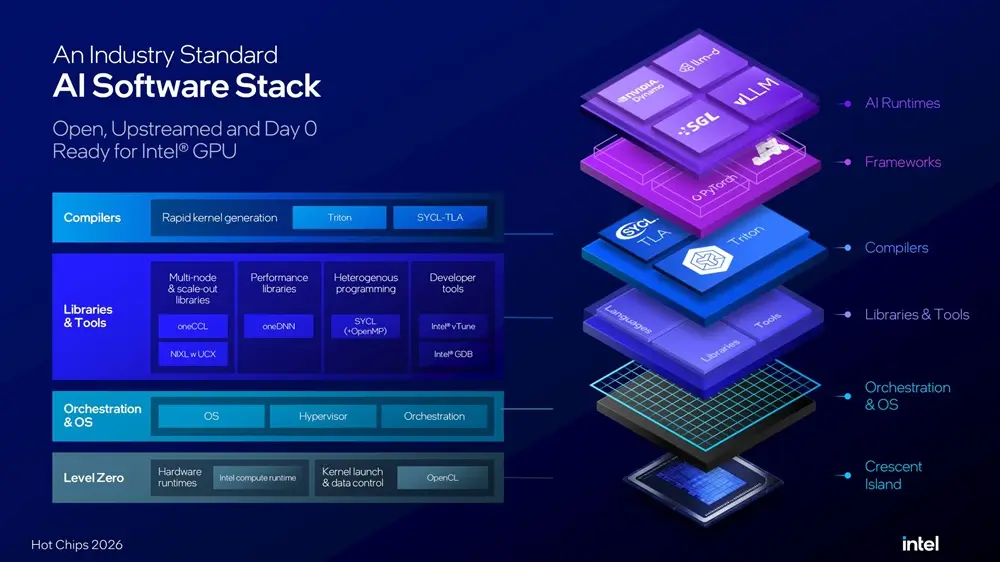
Nhằm phá vỡ ưu thế độc quyền phần mềm của đối thủ, Intel xây dựng dòng GPU D-Series trên nền tảng phần mềm mã nguồn mở hoàn chỉnh và tích hợp trực tiếp với các khung suy luận AI hàng đầu:
- Tương thích đa khung suy luận: Tích hợp sâu vào vLLM, SGLang, llm-d và NVIDIA Dynamo, cho phép các kỹ sư triển khai ngay lập tức các mô hình ngôn ngữ lớn và kiến trúc đa tác tử mà không cần chỉnh sửa mã nguồn.
- Cơ chế điều phối bộ nhớ đệm KV: Hỗ trợ định tuyến thông minh (KV-cache-aware routing) và giảm tải bộ nhớ đệm, tối ưu hóa thông lượng phục vụ đồng thời hàng nghìn người dùng.
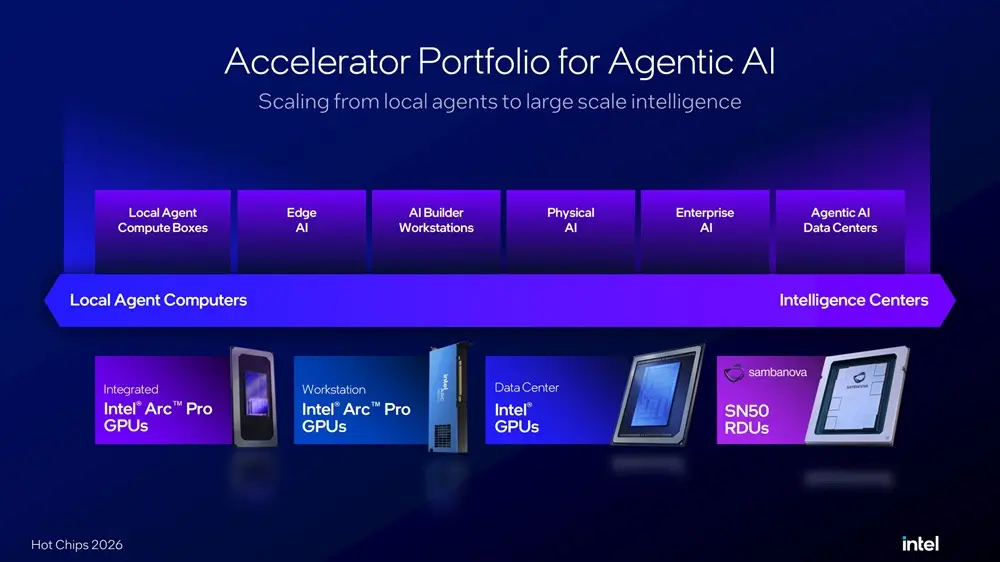
- Ngăn xếp phần mềm đồng nhất: Chia sẻ chung mã nguồn thông qua OneDNN, OpenVINO, PyTorch và Triton, đảm bảo khả năng chuyển đổi liền mạch giữa dòng card Arc Pro máy trạm và các dòng chip máy chủ Intel Xeon.
Về lộ trình thương mại, Intel xác nhận quá trình cung cấp mẫu thử nghiệm thực tế đang được tích cực tiến hành với các nhà sản xuất máy chủ (OEM/ODM), các đơn vị cung cấp dịch vụ đám mây và các hãng phát triển phần mềm AI độc lập. Dù mức giá chính thức chưa được công bố, sự xuất hiện của dòng GPU D-Series hứa hẹn sẽ định hình lại toàn diện bài toán đầu tư hạ tầng máy chủ AI trong thời gian tới.
Nguồn thông tin: wccftech.com & công bố kỹ thuật từ Intel Data Center Group.
Bài viết liên quan
Excel chạy chậm, Not Responding: sửa file hay đổi máy?
Đo thời gian tính, kiểm Excel 32-bit hay 64-bit, dọn công thức và file, rồi tính RAM và CPU cần có. Quy trình từng bước để quyết định sửa file hay đổi máy.
After Effects báo thiếu bộ nhớ: nguyên nhân, cách xử lý
Phân loại thông báo thiếu bộ nhớ của After Effects, tính dung lượng khung hình, kiểm RAM dùng chung với Premiere và mức RAM nên có cho máy dựng motion 2026.
Module Quang Marvell Đặt Bộ Nhớ Cách GPU 50m
Marvell ra mắt Photonic Fabric Memory Module: Đặt bộ nhớ HBM và DDR cách GPU 50m qua kết nối quang, giải bài toán Memory Wall cho AI.
AMD Rò Rỉ Ryzen AI 7 HX 455: 8 Nhân Với iGPU 16 CU
Rò rỉ AMD Ryzen AI 7 HX 455 (Gorgon Point): 8 nhân 16 luồng, 24MB L3 Cache, tích hợp iGPU Radeon 890M 16 CU nhân đôi đồ họa được Sicomp phân tích kỹ thuật.